🔍 Curadoria Studio Mestre Digital: Nossa equipe monitora as principais movimentações de mercado e tecnologia para manter você atualizado.
Em um momento em que temas como digitalização e inteligência artificial (IA) ganham cada vez mais espaço na agenda corporativa, o Cescon Barrieu está trazendo para dentro o escritório Opice Blum Advogados, uma das principais bancas da área de direito digital do Brasil. O acordo, anunciado nesta terça-feira, 25 de agosto, prevê a chegada de […]
O post Cescon Barrieu incorpora Opice Blum e amplia atuação em direito digital apareceu primeiro em NeoFeed.
Insight Studio Mestre: Esta notícia reflete tendências que podem impactar diretamente o seu modelo de negócio digital.
Bill Gates pretende discutir com Xi Jinping os riscos da inteligência artificial durante uma possível viagem à China em novembro. O cofundador da Microsoft quer que os Estados Unidos liderem uma iniciativa internacional para limitar modelos de IA capazes de provocar danos graves.
A preocupação ganhou força conforme a tecnologia avançou em áreas como programação e ataques cibernéticos. Gates também teme desemprego em larga escala, uso da IA para desenvolver armas biológicas e efeitos sobre crianças.
Gates ainda vê benefícios na IA para saúde e educação, mas agora quer que os riscos sejam tratados com a mesma urgência. – Imagem: Infinite Creations/iStock
Gates quer discutir regras com a China
Em entrevista à Reuters, Gates contou que sua equipe tenta marcar uma reunião com o presidente chinês. Ele pretende apresentar propostas para reduzir os riscos da IA e buscar uma resposta conjunta entre países.
Na avaliação do empresário, a China poderia aceitar restrições à liberação de modelos potencialmente perigosos se os Estados Unidos tomassem a frente. Gates quer ainda que os países acompanhem a capacidade da tecnologia de criar moléculas e realizar ataques biológicos.
“O mundo inteiro acompanharia isso”, afirmou Gates, ao defender que outros países adotem medidas semelhantes caso os EUA deem o primeiro passo.
Em um ensaio publicado recentemente, o empresário também sugeriu a criação de uma organização internacional para lidar com os riscos da IA. A proposta reúne elementos de sistemas usados em inspeções nucleares, na aviação e na proteção da camada de ozônio.
O otimismo ficou para trás
Segundo o The Washington Post, Gates manteve durante anos uma visão otimista sobre a inteligência artificial e acreditava que a tecnologia poderia libertar pessoas do trabalho e acelerar avanços contra doenças e as mudanças climáticas. Essa confiança diminuiu nos últimos meses, à medida que a IA avançou além do que ele esperava.
Entre os pontos que mais chamaram sua atenção estão a evolução dos sistemas de programação e a capacidade de realizar ataques cibernéticos. Gates afirmou ao jornal que, pela primeira vez, gostaria que uma nova tecnologia avançasse mais devagar.
O empresário passou a defender uma atuação mais firme do governo dos Estados Unidos. Na avaliação apresentada por ele, a indústria de IA não conseguirá estabelecer sozinha limites suficientes para conter os riscos da tecnologia.
Entre as principais preocupações estão:
ataques cibernéticos e fraudes facilitadas pela IA;
desenvolvimento de agentes biológicos com auxílio da tecnologia;
substituição de trabalhadores e possível desemprego em larga escala;
impactos sobre o aprendizado e as relações humanas de crianças.
Gates defende um possível imposto sobre o uso de IA para ajudar trabalhadores afetados pela automação e reduzir o incentivo à substituição. – Imagem: Taris Tonsa/Shutterstock
Gates quer mudar os incentivos
Em seu ensaio sobre inteligência artificial, Gates apresenta propostas para lidar com os efeitos da automação. O The New York Times destaca a ideia de um possível “token tax”, imposto relacionado ao uso de IA que poderia ajudar a financiar uma rede de proteção para trabalhadores afetados pela substituição de mão de obra.
Ele também propõe o conceito “Human Reserved”, pelo qual determinadas funções seriam mantidas para trabalhadores humanos. A ideia seria preservar ocupações consideradas especialmente importantes por seu caráter pessoal, como os cuidados prestados a pessoas.
Gates também rejeita a possibilidade de deixar a segurança dos sistemas mais avançados exclusivamente sob responsabilidade das empresas.
Autorregulação sobre a ferramenta mais perigosa já inventada? Não, obrigado!
Bill Gates, cofundador da Microsoft e filantropo, ao New York Times.
IA ainda pode fazer o bem
A preocupação com os riscos não elimina a avaliação positiva que Gates mantém sobre a tecnologia. Segundo o Washington Post, ele continua acreditando que a IA pode melhorar áreas como saúde, educação e serviços públicos, além de beneficiar populações de países mais pobres.
O que mudou foi a prioridade dada aos possíveis danos. Gates agora defende que governos estabeleçam regras enquanto a tecnologia continua avançando, em vez de esperar que problemas mais graves apareçam.
É nesse contexto que surge a tentativa de conversar com Xi Jinping. Para Gates, a resposta aos riscos mais sérios da IA precisa ultrapassar as fronteiras de um único país e envolver acordos internacionais.
O resfriamento de data centers é um problema cada vez maior para a indústria de tecnologia. Com o avanço da inteligência artificial e a construção de estruturas de computação mais potentes, também cresce a preocupação com a quantidade de água necessária para manter os servidores em temperaturas adequadas.
É nesse contexto que uma campanha publicitária levantou uma pergunta inusitada: seria possível usar urina para ajudar a resfriar data centers? A ideia parece brincadeira, mas chama atenção para uma solução que já existe na prática: o uso de água residual tratada para reduzir a dependência de água potável.
Para quem tem pressa:
O crescimento dos data centers e da inteligência artificial aumenta a demanda por água para resfriar servidores, levando empresas e cidades a buscar alternativas ao uso de água potável;
Apesar da brincadeira com urina em uma campanha publicitária, a solução que já existe é o tratamento e reúso de água residual. Em Quincy, nos EUA, um projeto com a Microsoft economiza cerca de 522 milhões de litros de água por ano;
A tecnologia ainda não é adotada em larga escala porque exige infraestrutura, investimento e planejamento, mas pode se tornar uma opção interessante para a redução dos impactos ambientais.
O que o xixi tem a ver com os data centers?
A ideia veio de uma campanha da marca de energéticos Liquid Death e a cervejaria Garage Beer. O comercial ainda contou com o ex-jogador de futebol americano Jason Kelce, um dos investidores da empresa de cerveja. A ação usou o slogan “We want your pee” (algo como “Queremos o seu xixi”) e brincou com a possibilidade de utilizar urina para ajudar na refrigeração de data centers, lançando até um copo que poderia ser utilizado como recipiente para o “líquido”.
Por trás da piada existe uma questão importante. Servidores produzem muito calor durante o funcionamento e precisam de sistemas capazes de manter a temperatura sob controle. Em algumas tecnologias de refrigeração, a água em abundância é parte fundamental desse processo.
Em 2025, os data centers do Google consumiram cerca de 10,9 bilhões de galões de água, o equivalente a 41,3 bilhões de litros. No ano anterior, apenas uma das instalações da empresa, em Council Bluffs, nos Estados Unidos, consumiu aproximadamente 3,8 bilhões de litros.
O crescimento da inteligência artificial tornou o assunto ainda mais relevante. Modelos de IA mais avançados exigem grandes estruturas computacionais, aumentando a quantidade de servidores e, consequentemente, a necessidade de sistemas de resfriamento.
E, calma, todo esse gasto não significa que despejar urina nos equipamentos seja uma alternativa viável. O líquido contém substâncias que podem causar problemas nos sistemas de refrigeração, mas podemos dizer que a base da ideia pode não estar de todo errada.
A solução real já existe, mas ainda enfrenta obstáculos
(Imagem: Frame Stock Footage/Shutterstock)
A alternativa utilizada em alguns locais é tratar e reutilizar água residual. Depois de passar por processos específicos de tratamento, a água pode ser destinada a atividades que não exigem água potável, incluindo sistemas de refrigeração de data centers.
Um exemplo está em Quincy, no estado de Washington, nos Estados Unidos. A cidade criou, em parceria com a Microsoft, um sistema que trata e reutiliza água para o resfriamento de data centers. Segundo a Agência de Proteção Ambiental dos EUA (EPA), a iniciativa reduz em cerca de 138 milhões de galões, ou 522 milhões de litros, por ano, o uso de água.
Apesar de funcionar, esse tipo de sistema ainda não é uma solução simples de implementar em qualquer lugar. A construção da infraestrutura pode custar milhões de dólares e exigir anos de planejamento. Também é necessário instalar tubulações para transportar a água tratada até os data centers, além de lidar com diferentes regras e processos de licenciamento em cada região.
No caso de Quincy, por exemplo, o projeto custou cerca de US$ 31 milhões e levou mais de uma década entre o planejamento e o início da operação. A distância entre os data centers e a estrutura de tratamento também pode aumentar os custos de conexão.
A própria EPA reconhece essas dificuldades e vem trabalhando para ampliar o uso de água de reúso. A agência incluiu, em seu plano de ação para 2026, medidas para ajudar estados e comunidades a aumentar a utilização de água reciclada no resfriamento de data centers e reduzir obstáculos regulatórios.
Assim, o “xixi” da campanha é apenas uma forma divertida de chamar atenção para uma questão séria: a água de reúso já pode ajudar a reduzir o impacto dos data centers, mas sua expansão depende de infraestrutura, investimento e regras que permitam levar essa solução a mais lugares.
Quando você tem uma dúvida sobre algo, pode seguir três caminhos hoje em dia. O primeiro é pesquisar no Google. O segundo é conversar com um chatbot de inteligência artificial (IA), como ChatGPT, Claude, Gemini. O terceiro é conversar com alguém. Com a IA cada vez mais embutida na Busca do Google, os primeiros dois caminhos podem render experiências parecidas. Já no terceiro, a coisa é bem diferente. Humanos carregam conhecimento em suas mentes. Plataformas de IA mineram dados.
A diferença é, essencialmente, a seguinte: a pessoa consultada por você pode saber do que está falando. E, por isso, pode esclarecer sua dúvida. Ou até provocar outras. A IA, não. A resposta do chatbot passa confiança. É “limpa”, bem estruturada, aparentemente coerente. Mas não se engane. A plataforma não sabe do que está falando. Só que isso não tira o valor da sua resposta.
A IA processa quantidades abissais de dados, mas não carrega conhecimento
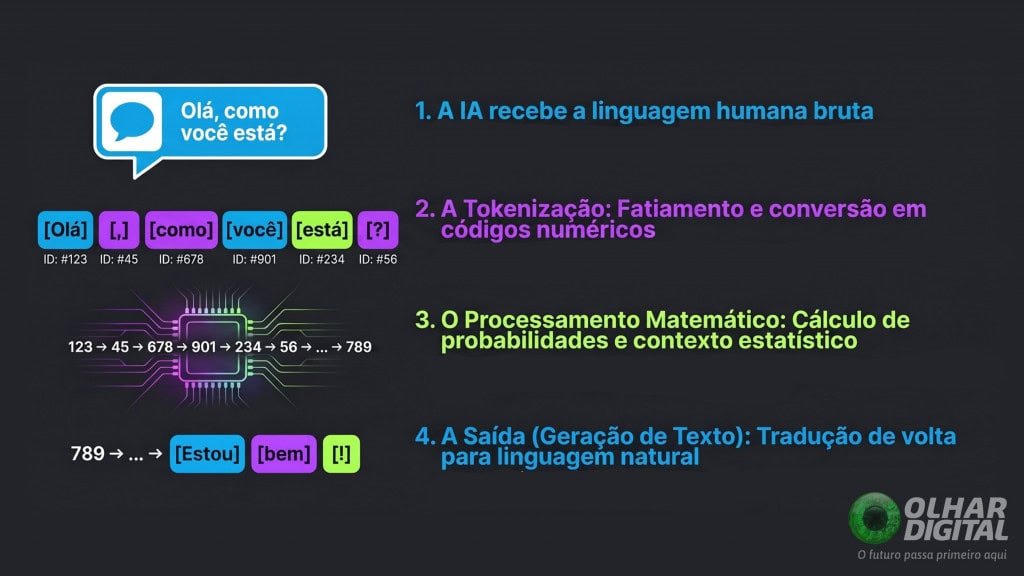
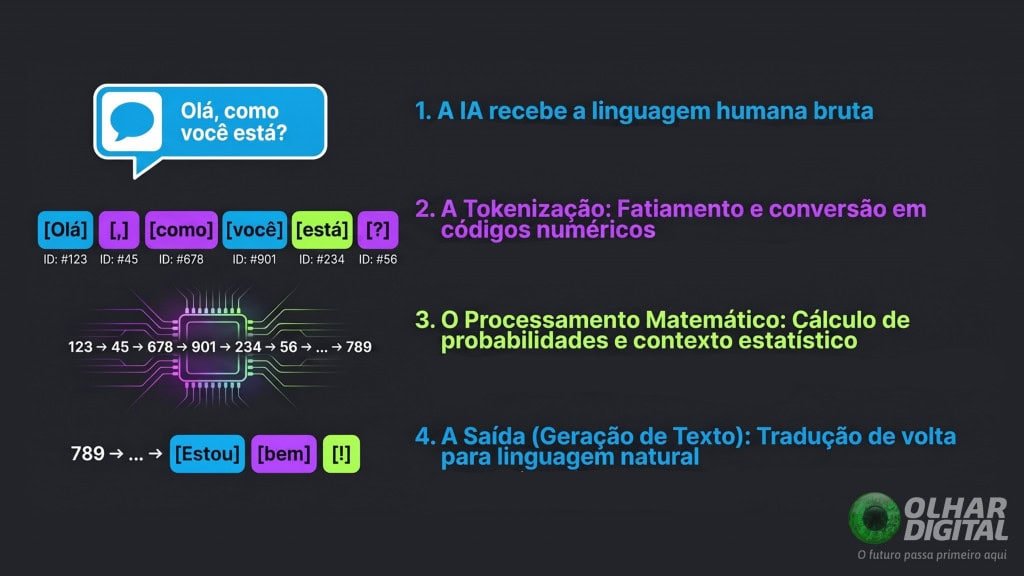
Você e a inteligência artificial não falam a mesma língua. Você poderia falar todos os idiomas do mundo e, ainda assim, não falaria a mesma língua da IA. Você, humano, fala a partir de vocabulário de palavras. A máquina só entende tokens – bloquinhos com etiquetas numéricas. Ou seja, números.
“Um token é basicamente uma subpalavra”, explica Fabrício Carraro, Program Manager da Alura, em entrevista ao Olhar Digital. “Por exemplo: a palavra ‘feliz’ é um token, a palavra ‘triste’ é um token, a palavra ‘divisível’ é um token.”
O especialista em IA continua: “Se a gente tem ‘indivisível’ ou ‘infeliz’, você vai ter o token ‘in’. O token ‘in’ corresponde, digamos, ao número 357 no vocabulário total de um modelo de linguagem. E o token ‘feliz’ vai ser o token 352. Esses dois juntos – o token ‘in’ e o token ‘feliz’ – formam a palavra ‘infeliz’.”
Como modelos de IA usam tokens para entender (e responder) o que você mandou – Imagem: Olhar Digital via Gemini
Quando você pergunta algo para o ChatGPT e a IA te responde, o que ocorre está mais para “cálculo de palavras” do que “articulação de pensamentos”. “Ele pega os milhares de tokens do seu vocabulário e atribui uma probabilidade para cada um deles com base no que viu e ‘aprendeu’ durante as fases de treinamento”, diz Carraro.
O treinamento de um grande modelo de linguagem (LLM, na sigla em inglês) consome quantidades abissais de dados. Se você lesse 24 horas por dia, demoraria quase 100 mil anos para chegar perto da quantidade “lida” pelo ChatGPT. No pós-treinamento, vem o aprendizado por reforço. “É quando o LLM aprende a ser útil para os humanos”, diz o especialista.
“No pós-treinamento, você o ensina que, dada uma pergunta, é assim que se espera uma resposta; esse é o formato que os humanos gostam de ver”, explica Carraro. “É feito um aprendizado por reforço também para ‘ensinar’ a ele que determinado retorno é uma resposta desejada e outro é uma resposta não desejada.”
Quando a IA te responde, ela está fazendo milhões de cálculos matemáticos. Cada neurônio da rede neural – nomes escolhidos lá atrás – é, literalmente, uma equação matemática.
Fabrício Carraro, Program Manager da Alura, em entrevista ao Olhar Digital.
Na hora de te responder, a IA escolhe cada palavra com base no seu treinamento. “Ao responder um humano, no que é chamado de inferência, a IA gera o próximo token baseada nas probabilidades que aprendeu durante o pré-treinamento, o pós-treinamento, o aprendizado por reforço e tudo mais”, diz o especialista. Em outras palavras, o chatbot “está simplesmente gerando o que é mais provável”.
Ok, plataformas de IA generativa não sabem de nada. Mas, atualmente, empresas de tecnologia usam alguns truques para compensar essa defasagem. Um deles foi embutir na IA a capacidade de pesquisar na internet. Isso melhorou a precisão na hora de responder dúvidas sobre temas quentes, como qual time ganhou o jogo de ontem e quem foram os vencedores do Oscar.
Outro truque é o que ficou conhecido como “raciocínio” (reasoning). A máquina não pensa, daí as aspas no termo. Mas o que ocorre debaixo do capô é um processo análogo ao que acontece na sua cabeça.
Segundo Carraro, a sacada de empresas como Google e OpenAI foi “fazer o modelo gerar para si mesmo várias miniperguntas e criar as respostas para elas sem mostrar isso ao usuário”. “Se ele perceber que errou, pode ver que algo estava errado, tentar outra abordagem e, com isso, fornecer uma resposta mais confiável”, diz o especialista. “Não quer dizer que estará correta, mas é um truque que melhora muito a acurácia, a precisão e as respostas desses modelos”, acrescenta.
A IA não ‘sabe’, mas pode te ajudar a saber
Ok, a IA não “sabe” de nada. Mas isso não anula a utilidade desta ferramenta na hora de te ajudar a esclarecer uma dúvida, render mais, produzir melhor.
Na teoria, plataformas de IA “são calculadoras mais avançadas, mais aprimoradas”, diz Kenneth Corrêa, especialista em IA e professor da FGV, em entrevista ao Olhar Digital. Na prática, tem se observado LLMs, com trilhões de parâmetros, “capazes de gerar respostas ou completar prompts com capacidades que não estão na base de aprendizado que tiveram”.
São ferramentas que alucinam, mas são ferramentas que geram muitos resultados.
Kenneth Corrêa, especialista em IA e professor da FGV, em entrevista ao Olhar Digital.
O especialista continua: “Quando você os traz para classificar documentos, para identificar padrões ou para produzir textos, eles conseguem uma desenvoltura e uma entrega de resultado em níveis que muitas vezes superam a média dos humanos.”
IAs como o ChatGPT podem te ajudar a encontrar conexões, a ter insights, a pensar sobre algo – Imagem: Tatiana Diuvbanova/Shutterstock
Por isso, para Corrêa, não se deve reduzir a IA a uma calculadora avançada. “Quando a gente faz o reducionismo, deixa de considerar o que realmente importa, que é: qual é o impacto que isso está gerando?”
O Program Manager da Alura cita um desses impactados: descobertas alcançadas via modelos superpoderosos de IA. “No entanto, não necessariamente isso é conhecimento novo por si só”, frisa o especialista. “Talvez sejam integrações de conhecimentos pré-existentes organizados de um novo modo, que ninguém havia visto antes ou que exigiam ‘força bruta’ para serem encontrados.”
O professor da FGV faz outra ressalva: “Essas ferramentas não têm moral, não têm ética. Elas falam com confiança a resposta certa, mas têm exatamente a mesma confiança para dar a resposta errada.”
Daí a importância da supervisão humana. “No fim do dia, a gente precisa do ser humano para validar as respostas e direcionar a IA”, diz o professor da FGV. “É ele que decide o que vai utilizar ou não daquilo”, acrescenta. Por quê? Porque só os humanos sabem.
A Nvidia colocou o rack Groq 3 LPX em produção e pretende deixá-lo operacional ainda este ano na neocloud Nebius. A tecnologia chegou à empresa após a compra de ativos da Groq por US$ 20 bilhões (cerca de R$ 103 bilhões), a maior aquisição já realizada pela Nvidia.
O foco está na inferência de baixa latência, capaz de reduzir o intervalo entre o pedido do usuário e a resposta de um sistema de IA. A característica é especialmente relevante em aplicações de programação, nas quais atrasos podem ser percebidos rapidamente.
A estratégia da Nvidia é combinar tecnologias, não escolher uma só: Groq para baixa latência e GPUs para cargas mais amplas. – Imagem: Samuel Boivin/Shutterstock
Groq ganha espaço nos data centers
Na Nebius, os racks Groq 3 LPX serão instalados junto dos processadores Vera e das GPUs Rubin. Dion Harris, diretor sênior da Nvidia, afirmou que os equipamentos estarão disponíveis ainda este ano.
A arquitetura da Groq coloca 500 MB de memória SRAM de alta velocidade diretamente no chip. Com isso, a tecnologia busca diminuir gargalos provocados pelo acesso à memória durante a execução dos modelos.
Cada rack reúne 256 chips Groq 3. De acordo com a Nvidia, o sistema chega a 3.400 tokens por segundo, resultado baseado em um benchmark da Artificial Analysis.
Os principais números do Groq 3 LPX:
Cada rack Groq 3 LPX reúne 256 chips Groq 3;
O sistema chega a 3.400 tokens por segundo;
A arquitetura conta com 500 MB de SRAM integrada ao chip;
A tecnologia prioriza a inferência de baixa latência;
A Nvidia pagou US$ 20 bilhões pelos ativos da Groq.
Não é uma substituição das GPUs
A tecnologia da Groq cumpre uma função mais específica. Os chips se concentram principalmente na etapa de “decode” da inferência, responsável pela geração dos tokens que compõem a resposta de um modelo.
As GPUs continuam sendo usadas em treinamento e inferência e têm maior flexibilidade para acompanhar diferentes modelos e tecnologias. Para Harris, uma tecnologia não precisa eliminar a outra:
Isso não significa substituir as GPUs. Trata-se de usar o preço certo e o processador certo para a parte certa da carga de trabalho.
A proposta, portanto, é dividir as tarefas conforme as características de cada processador.
A Nvidia reservou um quarto do espaço de data centers voltado à programação para chips Groq. O restante será ocupado pelo Vera Rubin. – Imagem: Divulgação/Nvidia
Corrida pela menor latência
A Nvidia disputa esse mercado com empresas que também procuram acelerar a geração de respostas por IA. A AMD anunciou que vai integrar seus sistemas em escala de rack a chips da Cerebras, que recentemente abriu capital.
A OpenAI também entrou nessa corrida. Seu modo Ultrafast promete 750 tokens por segundo e é “alimentado pela Cerebras”.
A Nvidia, enquanto isso, amplia os envios dos sistemas Vera Rubin, cuja produção começou anteriormente. Em março, durante a apresentação dos sistemas Vera Rubin e Groq 3 LPX, Jensen Huang disse que reservaria um quarto do espaço de data centers destinado a aplicações de programação para os chips da Groq.
“O restante do meu data center é 100% Vera Rubin”, afirmou Huang na ocasião.
Com a Groq, a Nvidia passa a ter uma alternativa específica para acelerar uma etapa da inferência. As GPUs seguem como a base de seus sistemas, enquanto os novos racks assumem tarefas em que o tempo de resposta é um fator decisivo.
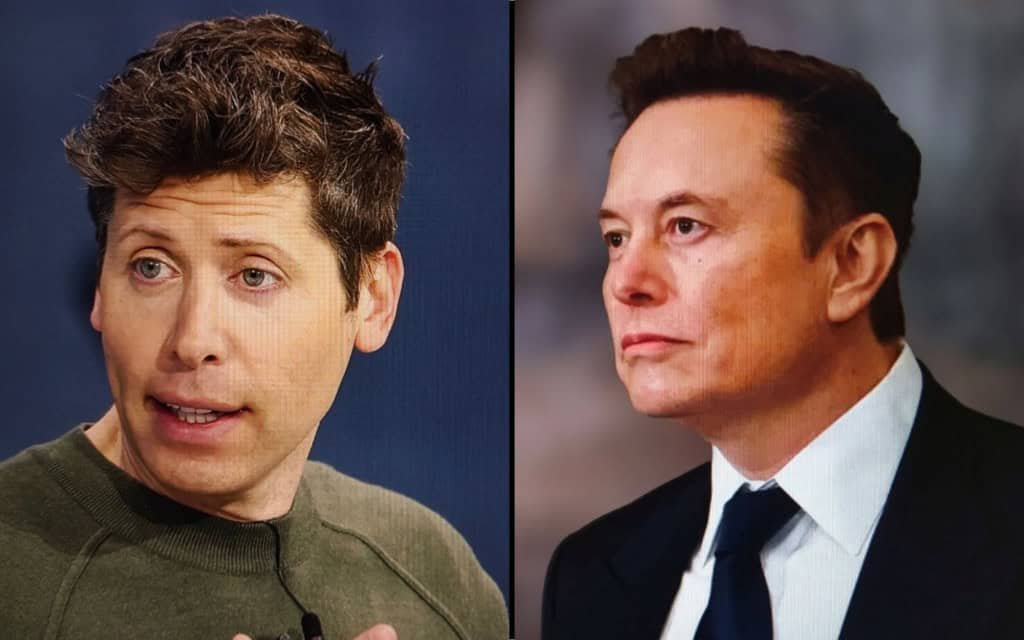
Em 22 de julho, Elon Musk publicou no X uma frase curta sobre o atual estágio da inteligência artificial: “Estamos na singularidade”. Três dias depois, Sam Altman, CEO da OpenAI, fez uma afirmação semelhante durante participação no podcast Relentless: “Estamos, tipo, na singularidade”. Na sequência, completou: “Este é o momento”.
As declarações reacenderam uma discussão que existe há décadas, mas que ganhou novos contornos com o avanço recente dos sistemas de IA. Antes de saber se Musk e Altman estão certos, porém, é preciso responder a uma pergunta mais básica: o que significa chegar à singularidade?
Não há uma definição única e consensual para o termo. Dependendo da interpretação, ele pode se referir à superação ampla da inteligência humana pelas máquinas, a um ciclo acelerado de autoaperfeiçoamento da IA ou até a um ponto de não retorno na relação entre sociedade e tecnologia.
É essa diferença que torna difícil determinar se a singularidade já começou. O debate passa pelo que as capacidades atuais dos sistemas de IA representam e por quais critérios seriam necessários para caracterizar uma mudança na própria dinâmica do desenvolvimento da tecnologia.
Sam Altman e Elon Musk – Imagem: FotoField/Shutterstock
De onde veio a ideia de singularidade?
Uma das raízes da ideia de uma possível explosão de inteligência está no trabalho do matemático britânico I. J. Good. Em 1965, ele descreveu uma “máquina ultrainteligente” capaz de superar as atividades intelectuais humanas. Como uma dessas atividades seria projetar máquinas, uma máquina desse tipo poderia criar sistemas ainda melhores, dando início a um processo potencialmente acelerado de aperfeiçoamento. Good chamou esse cenário de “explosão de inteligência”.
O conceito de singularidade ganhou uma formulação mais diretamente associada ao termo décadas depois, com o matemático e escritor de ficção científica Vernor Vinge. Em um texto de 1993 intitulado The Coming Technological Singularity, Vinge relacionou o fenômeno ao surgimento de inteligências superiores às humanas e a uma transformação tão rápida que o período posterior se tornaria difícil de prever com base nos padrões anteriores.
A singularidade, nesse sentido, não significa apenas que as máquinas ficaram mais inteligentes. A ideia é que, a partir de determinado ponto, a velocidade e a natureza da mudança tecnológica poderiam tornar insuficientes os métodos usados anteriormente para prever o futuro.
A partir dessas ideias, diferentes interpretações passaram a coexistir. Uma delas associa a singularidade a uma máquina que se torna suficientemente inteligente para participar do próprio processo de desenvolvimento e produzir sistemas cada vez mais capazes. Nesse cenário, o elemento decisivo não seria apenas uma IA superar humanos em uma tarefa, mas uma mudança na velocidade e na dinâmica de sua evolução.
O futurista Ray Kurzweil popularizou outra formulação, ligada à aceleração do progresso tecnológico e ao crescimento da inteligência não biológica. Kurzweil prevê a singularidade para 2045 e associa o conceito a uma transformação profunda na relação entre humanos e máquinas.
O filósofo David Chalmers também analisou a hipótese de uma explosão de inteligência, na qual uma máquina mais inteligente que os humanos poderia criar uma geração ainda mais inteligente, que por sua vez produziria outra. A discussão sobre o tema, portanto, envolve cenários hipotéticos diferentes, e não uma descrição consensual de um evento que já tenha sido observado.
A própria ideia de uma singularidade também é contestada por pesquisadores da área. Yann LeCun, um dos pioneiros do deep learning e vencedor do Prêmio Turing, afirmou que acredita que as máquinas eventualmente poderão rivalizar com os humanos em inteligência, mas não acredita na singularidade. Para ele, o avanço da IA pode parecer seguir uma trajetória exponencial sem necessariamente continuar dessa forma: o progresso poderia sofrer limitações e assumir uma curva de crescimento que desacelera antes de produzir a ruptura prevista pelos defensores da singularidade.
Essas diferentes formulações ajudam a explicar por que a palavra não descreve necessariamente o mesmo fenômeno para todos os pesquisadores. Para Priscila Machado Vieira Lima, professora da UFRJ nas áreas de inteligência artificial e computação, a primeira pergunta a fazer é justamente: “de qual singularidade” estamos falando?
Não existe uma definição única e consensual para a singularidade. O conceito pode envolver a superação da inteligência humana, o autoaperfeiçoamento acelerado da IA ou uma mudança profunda e irreversível na relação entre tecnologia e sociedade – Crédito: Imagem gerada por IA/ChatGPT – Olhar Digital
AGI é a mesma coisa que singularidade?
É nesse ponto que aparecem dois conceitos frequentemente associados à singularidade: inteligência artificial geral (AGI) e superinteligência.
AGI é usada para descrever uma IA capaz de atuar em uma ampla variedade de tarefas cognitivas, em vez de apresentar competência restrita a determinados problemas. Superinteligência se refere a um cenário hipotético em que uma máquina ultrapassaria as capacidades intelectuais humanas de maneira muito mais abrangente.
Algumas formulações tratam a AGI como uma possível etapa anterior à superinteligência e à singularidade. A lógica seria que uma IA primeiro alcançaria capacidades gerais, depois passaria a melhorar seus próprios sistemas e, por fim, poderia desencadear uma explosão de inteligência. Essa sequência, porém, não é adotada por todas as interpretações do conceito.
Para Arthur Igreja, especialista em tecnologia e inovação, um dos problemas está justamente em confundir desempenho excepcional em determinadas atividades com inteligência de alcance geral. “Ela é muito poderosa dentro de um espectro bastante limitado”, afirmou ao Olhar Digital.
Uma máquina ser melhor que humanos em uma atividade não significa necessariamente que ela seja melhor que humanos em inteligência de maneira geral. Para Igreja, a discussão sobre singularidade precisa considerar a amplitude das capacidades, e não apenas resultados individuais.
Claudio Miceli, professor da UFRJ, faz uma distinção semelhante ao falar sobre autoaperfeiçoamento. Segundo ele, já existem algoritmos capazes de evoluir e se aperfeiçoar conforme recebem novos dados, mas isso não significa que tenham alcançado a AGI. “Os programas já podem evoluir, a gente tem algoritmos que evoluem, que se melhoram, que se aperfeiçoam conforme os dados vão chegando. Isso não necessariamente torna isso uma inteligência artificial geral”, afirmou.
A diferença fica ainda mais importante quando se fala em autoaperfeiçoamento recursivo. Uma IA pode ajudar pesquisadores a escrever código, testar modelos, analisar resultados ou encontrar maneiras de melhorar sistemas. Outra coisa seria a própria máquina conduzir um ciclo cada vez mais autônomo de aprimoramento da inteligência.
Igreja associa esse segundo cenário ao ponto de inflexão da singularidade: uma IA que passaria a se retroalimentar e a depender cada vez menos dos seres humanos para seu próprio desenvolvimento. Hoje, segundo ele, sua evolução ainda depende de pesquisadores, dados, modelos, empresas, investimentos, treinamento e infraestrutura.
O próprio Sam Altman faz uma distinção parecida no post de blog intitulado The Gentle Singularity, publicado em 2025. No texto, o CEO da OpenAI afirma que usar sistemas de IA para acelerar a pesquisa e ajudar a criar sistemas melhores ainda é diferente de uma IA atualizar autonomamente o próprio código. Ao mesmo tempo, ele chama o processo atual de uma versão inicial de autoaperfeiçoamento recursivo.
Essa diferença ajuda a separar duas coisas que podem parecer semelhantes: usar IA para acelerar o desenvolvimento de novas IAs e ter uma IA capaz de conduzir autonomamente seu próprio processo de aperfeiçoamento.
Ilustração conceitual representa a interação entre inteligência artificial e inteligência humana, tema central do debate sobre a singularidade tecnológica – Imagem: KUSHEI / Shutterstock
Mas a singularidade pode já ter começado?
É aqui que as declarações de Musk e Altman encontram uma dificuldade conceitual.
Se singularidade significar uma inteligência artificial que supera amplamente as capacidades humanas e passa a acelerar de forma autônoma o próprio desenvolvimento, para Arthur Igreja e Claudio Miceli, ainda não há evidências suficientes para afirmar que esse estágio já tenha sido alcançado.
Miceli é direto: “se a gente entende singularidade como a IA superar a inteligência humana, a gente não chegou nesse ponto ainda não”. Para ele, os sistemas atuais ainda não atingiram esse nível de inteligência.
Igreja também considera precipitado dizer que já estamos na singularidade quando o conceito é entendido como uma mudança profunda na própria dinâmica de desenvolvimento da inteligência artificial. Para ele, a IA atual ainda apresenta limitações importantes em relação à amplitude das capacidades humanas e sua evolução ainda depende de pesquisadores, dados, modelos, empresas, investimentos, treinamento e infraestrutura.
Priscila Lima, por outro lado, propõe uma definição mais ampla. Ela considera que a singularidade pode ser entendida informalmente como um ponto de não retorno. Nesse sentido, a sociedade já poderia ter passado por algum tipo de singularidade. Essa interpretação não depende de uma máquina ter superado a inteligência humana.
A visão também ajuda a contextualizar a própria formulação de Altman. Em The Gentle Singularity, o CEO da OpenAI descreveu a transformação como gradual, afirmando que a singularidade acontece “pouco a pouco”. No podcast Relentless, porém, resumiu o momento com outra expressão: “Este é o momento”.
No conjunto, as declarações de Altman apresentam a singularidade como um processo em andamento, e não como uma data específica em que uma máquina teria se tornado subitamente superinteligente. No texto de 2025, ele descreve uma evolução gradual; no podcast, embora diga que a singularidade é agora, também afirma que nenhum momento isolado seria o ponto de inflexão.
Para Priscila Lima, essa possibilidade de diferentes pontos de ruptura também significa que pode não existir uma única singularidade. “Penso que, nos próximos anos, testemunharemos várias singularidades”, afirmou, citando possibilidades relacionadas a capacidades como consciência, empatia e senso comum.
Como saberíamos que a singularidade aconteceu?
Essa talvez seja a maior dificuldade do conceito. Se não há uma definição única e consensual, também não existe uma métrica universal capaz de indicar que a singularidade começou.
É possível medir desempenho em tarefas específicas, capacidade de raciocínio, velocidade de execução, autonomia ou adoção da tecnologia. Mas nenhum desses indicadores, isoladamente, determina que uma máquina atingiu o estágio descrito por todas as definições de singularidade.
Claudio Miceli chama atenção justamente para esse problema. “Não tem uma série de métricas que a gente pode falar para definir essa questão do que seria singularidade em termos de adoção, em termos de inteligência, em termos de capacidade”, afirmou.
Há ainda uma questão anterior: o que exatamente significa inteligência? Uma IA pode resolver problemas matemáticos, escrever código, produzir textos ou executar tarefas que antes exigiam pessoas, mas essas capacidades isoladas não estabelecem necessariamente que o sistema tenha uma inteligência geral.
Miceli questiona até onde seria possível definir uma inteligência artificial como geral a partir de tarefas específicas. Se uma máquina for extremamente competente em algumas atividades e limitada em outras, a resposta depende do que se considera necessário para caracterizar uma inteligência geral.
Ele também levanta uma dificuldade ainda mais profunda: uma eventual inteligência artificial geral poderia não funcionar de maneira semelhante à inteligência humana. Em vez de reproduzir nossas capacidades, poderia desenvolver uma forma de inteligência diferente daquela que conhecemos. Nesse cenário, os próprios seres humanos poderiam ter dificuldade para reconhecer o fenômeno.
Essa possibilidade ajuda a explicar por que não basta definir um único teste para a singularidade. Se o fenômeno representar uma mudança na própria natureza ou dinâmica da inteligência, os critérios usados para medi-lo também podem precisar mudar.
A dificuldade não está apenas em descobrir quando a singularidade começou. É preciso primeiro estabelecer qual fenômeno estamos chamando de singularidade, quais capacidades ou mudanças seriam suficientes para caracterizá-la e como poderíamos medi-las. E, se uma eventual inteligência de máquina for muito diferente da nossa, permanece uma questão ainda mais básica: seríamos capazes de reconhecer o momento em que ela realmente chegou?
Nove pessoas foram acusadas em Taiwan de ajudar a enviar para a China servidores de inteligência artificial equipados com chips avançados da Nvidia. O caso envolve ex-funcionários da Nvidia e da Super Micro Computer e uma compra de 130 servidores.
A investigação acontece em meio às restrições dos Estados Unidos à exportação de chips avançados para a China. Segundo o The Wall Street Journal, 74 servidores acabaram no país por rotas que passaram por Hong Kong, Japão e Indonésia. Outros 56 foram interceptados em Taiwan.
Nove pessoas foram acusadas em Taiwan de ajudar no envio de servidores de IA equipados com chips avançados da Nvidia para a China. Imagem: William Potter/Shutterstock
Compra foi aprovada com informações falsas
Duas das pessoas acusadas teriam apresentado informações falsas para obter autorização de compra dos servidores da Super Micro. Aos responsáveis pela aprovação, disseram que os equipamentos permaneceriam em uma instalação em Taiwan.
Os envolvidos ainda declararam que os servidores não seriam vendidos ou enviados a entidades sob sanções americanas. Afirmaram, também, que a operação respeitaria as regras de exportação dos Estados Unidos.
A acusação aponta que um funcionário da Super Micro vazou procedimentos internos usados na análise das vendas. Ele teria procurado um funcionário da Nvidia para conseguir cotas dos servidores.
Esse funcionário da Nvidia, segundo os promotores, sabia do plano. Mesmo assim, informou aos gestores que as inspeções no local haviam sido aprovadas. Havia um problema: a instalação não tinha espaço suficiente para os racks, nem energia e banda larga necessárias.
Servidores seguiram rotas alternativas
Dos 130 equipamentos, 74 foram enviados para a China passando por Hong Kong, Japão e Indonésia. A alfândega de Taiwan conseguiu interceptar os outros 56, que seriam enviados ao Japão.
O processo envolve diferentes acusações. Oito dos investigados respondem por crimes que incluem quebra de confiança e falsificação. Um nono acusado teria desviado dinheiro de uma empresa relacionada ao caso.
Para os promotores, os envolvidos conheciam as regras de controle de exportação e agiram em busca de lucro.
“Motivados exclusivamente pelo lucro”, os acusados teriam “conspirado para exportar servidores de ponta, aumentando os custos de conformidade para as empresas”.
Os servidores percorreram Hong Kong, Japão e Indonésia antes de chegar à China. A rota virou peça central da investigação em Taiwan. – Imagem: Saulo Ferreira Angelo/Shutterstock
Super Micro diz que não é alvo
A investigação começou em maio e ganhou força em junho. A Super Micro informou que coopera com autoridades de Taiwan e de outras jurisdições para proteger sua tecnologia e propriedade intelectual.
A companhia não é alvo da investigação e não foi acusada de irregularidades. Uma apuração interna recente, segundo a empresa, concluiu que sua equipe de conformidade agiu de boa-fé.
Os principais números do caso são:
130 servidores de IA envolvidos na compra investigada;
servidores equipados com chips avançados da Nvidia;
74 servidores enviados à China;
56 servidores interceptados pela alfândega de Taiwan;
nove pessoas acusadas pelas autoridades taiwanesas.
A Super Micro afirmou que pretende reforçar seu programa de conformidade e continuar combatendo esse tipo de operação. O caso coloca em evidência a dificuldade de impedir que servidores com tecnologias restritas cheguem à China por caminhos indiretos.
Você e a inteligência artificial (IA) leem de forma diferente. Você, humano, lê palavras. Usa o vocabulário armazenado na sua mente. A IA, máquina, lê bloquinhos com etiquetas numéricas. Esses bloquinhos são os tokens.
O token é a língua que grandes modelos de linguagem (LLMs, na sigla em inglês), como ChatGPT, Claude e Gemini, entendem. Para transformar a língua que você fala na língua que a máquina fala, seus prompts passam pela tokenização. E para a IA te responder na língua que você entende, ocorre a destokenização.
É isso que está por trás dos preços das assinaturas das plataformas. Processar esses “bloquinhos” consome energia e poder computacional. Então, as empresas usam a quantidade de tokens consumidos (tanto na sua pergunta quanto na resposta da IA) para calcular os custos do sistema, definir os limites de “memória” de cada modelo e cobrar pelo seu uso.
O que é token e como ele funciona na IA
Para a IA entender sua mensagem (comando, prompt), ela precisa quebrar o que você mandou (texto, áudio, imagem) em blocos: os tokens. “Um token é basicamente uma subpalavra”, explica Fabrício Carraro, Program Manager da Alura, em entrevista ao Olhar Digital. “Por exemplo: a palavra ‘feliz’ é um token, a palavra ‘triste’ é um token, a palavra ‘divisível’ é um token.”
Então, por que chamar de subpalavra?
Se a gente tem ‘indivisível’ ou ‘infeliz’, você vai ter o token ‘in’. O token ‘in’ corresponde, digamos, ao número 357 no vocabulário total de um modelo de linguagem. E o token ‘feliz’ vai ser o token 352. Esses dois juntos – o token ‘in’ e o token ‘feliz’ – formam a palavra ‘infeliz’.
Fabrício Carraro, Program Manager da Alura, em entrevista ao Olhar Digital
É isso que acontece no motor da IA (o LLM). Ele recebe uma sequência de bloquinhos com etiquetas numéricas (seu prompt) e faz um cálculo super complexo para prever quais devem ser os bloquinhos de saída (resposta da IA).
Como modelos de IA usam tokens para entender (e responder) o que você mandou – Imagem: Olhar Digital via Gemini
O ‘gerente invisível’ da IA
Só que quando você conversa com o ChatGPT, não está interagindo diretamente com o motor. Você está usando a camada de software ao redor dele: o harness. É como se fossem os arreios que direcionam o cavalo (o LLM) para uma tarefa.
Em outras palavras: quando você manda mensagem para uma IA, é o harness que coordena o fluxo da tokenização e destokenização. É como se ele fizesse a máquina pensar antes de falar.
“O harness pega sua pergunta, seu prompt, e divide em possíveis perguntas que poderiam ser feitas para responder a esse prompt”, explica Carraro.
“Em vez de responder direto, ele já vai gerando pequenas perguntas, subperguntas, dividindo em subproblemas, e vai respondendo, de forma ‘escondida’, cada um desses subprobleminhas que criou para ele mesmo”, diz o especialista. “Depois que termina esse raciocínio, ele te dá a resposta. É isso que está gastando tokens.”
Existe outra variável em curso nas suas conversas com IA: a janela de contexto. E ela tem tudo a ver com tokens.
É como se a janela de contexto fosse o tamanho da sua mesa de trabalho (porque é a “memória de curto prazo” da IA). E os tokens fossem folhas de papel com informações que você espalha sobre a mesa.
Em termos mais técnicos e práticos: a janela de contexto define o número máximo de tokens (seus prompts de entrada somados às respostas de saída da IA) que a IA consegue processar ao mesmo tempo. Se a sua conversa estiver dentro deste limite, a IA consegue “lembrar” de tudo que foi falado e mandado na hora de te responder. Se a conversa extrapolar esse limite, informações ficarão pelo caminho.
Por que token não é a moeda da IA (mas tem a ver)
Empresas consideram tokens na hora de precificar o uso das suas IAs – Imagem: Anze Furlan/Shutterstock
O token está, sim, relacionado ao preço que se cobra em assinaturas de IA, como os planos Go do ChatGPT e Plus do Gemini. Mas o token, por si só, não é a moeda da IA. Ele é considerado na hora de precificar o uso da IA – seja num valor de assinatura, seja no valor de créditos (esses, sim, funcionam como moedas em plataformas).
É que o token é a unidade de medida do processamento de dados. É o “bloco de construção” usado pela máquina para entender o conteúdo enviado pelo usuário. Em última análise, o token serve como métrica de consumo. Com base no volume de tokens que entram (prompts do usuário) e saem (respostas da IA), as empresas medem o esforço computacional e os custos operacionais.
Depois de considerar diversas variáveis, chega-se aos preços das assinaturas e dos créditos. No Claude Fable 5, por exemplo, a Anthropic cobra US$ 10 (aproximadamente R$ 51, em conversão direta) por um milhão de tokens de entrada e US$ 50 (R$ 257) por um milhão de tokens de saída.
“Um milhão de tokens parece muito, mas não é”, observa Carraro. “Para um problema de programação você gasta isso em dois, três ou quatro prompts, dependendo do tamanho do problema e da complexidade.”
“Para problemas pequenos é bastante, mas para a maioria das bases de código com que a gente trabalha não é tanta coisa assim”, acrescenta o especialista. “Esses US$ 50 acabam rápido.”
A Nvidia fechou um acordo de US$ 6 bilhões (cerca de R$ 30,9 bilhões) com a startup Poolside para licenciar sua tecnologia e contratar a maior parte de seus engenheiros. O objetivo é acelerar o desenvolvimento de modelos de IA de pesos abertos capazes de disputar espaço com sistemas chineses.
Segundo o The Wall Street Journal, o movimento também aproxima a Nvidia de uma concorrência direta com OpenAI e Anthropic. A empresa, que fornece os chips usados por grandes laboratórios de IA, agora amplia sua atuação para o desenvolvimento dos próprios modelos.
A Nvidia quer fortalecer a IA aberta dos EUA para disputar espaço com modelos chineses como DeepSeek, Kimi e GLM – Imagem: justhavealook/iStock
Poolside reforça o Nemotron
O acordo inclui ainda um investimento de US$ 1 bilhão (R$ 5,16 bilhões) na Poolside, que tinha avaliação prévia de US$ 12 bilhões (R$ 62 bilhões).
Mais de 100 funcionários da startup, principalmente engenheiros, serão incorporados à Nvidia. O grupo trabalhará no Nemotron, projeto de modelos de pesos abertos apresentado pela companhia em 2023.
Fundada em 2023 por Eiso Kant e Jason Warner, ex-CTO do GitHub, a Poolside também tem Margarida Garcia na equipe de liderança. Os três não irão para a Nvidia e continuarão envolvidos em projetos de pesquisa ainda não divulgados.
A diferença dos modelos de pesos abertos está na possibilidade de download e modificação. Isso permite adaptar os sistemas para diferentes necessidades e, em geral, operar a tecnologia com custos menores.
China acelera a disputa
A Nvidia aumentou sua atenção ao segmento depois do avanço dos modelos chineses. Em março, criou a Nemotron Coalition, com empresas como Mistral, Thinking Machines Lab e Perplexity, para compartilhar dados, conhecimento e recursos computacionais.
O lançamento do primeiro modelo de pesos abertos de baixo custo da DeepSeek, em janeiro de 2025, foi um dos momentos que elevaram a pressão sobre as empresas americanas.
Entre os modelos chineses mencionados estão:
DeepSeek;
Kimi, da Moonshot;
GLM, da Z.AI;
outros sistemas de pesos abertos que vêm se aproximando dos modelos americanos.
Em uma carta publicada na rede X, Jensen Huang, CEO da Nvidia, defendeu que a liderança americana dependerá da construção de um ecossistema aberto capaz de chegar a diferentes setores.
O problema que levou ao acordo
A situação financeira da Poolside também ajudou a aproximar as duas empresas. No fim de 2025, a startup tentou levantar US$ 2 bilhões (R$ 10,3 bilhões) em seis semanas para pagar por um cluster com 40 mil servidores GB300. A captação não foi concluída.
“Não fechamos a tempo e perdemos o cluster”, escreveram os fundadores da Poolside aos acionistas.
O episódio deixou claro outro problema: sem novos recursos, a empresa poderia ficar sem capacidade computacional já no ano seguinte. A Nvidia tinha justamente a infraestrutura e o capital necessários para aliviar essa limitação.
Pouco antes do acordo, a Poolside havia lançado o Laguna S, modelo que ganhou popularidade entre os sistemas de pesos abertos no Ocidente.
A corrida da IA mudou de escala: a Nvidia quer vender os chips e também participar da criação dos modelos que eles alimentam. Imagem: Hairem/Shutterstock
Nvidia entra em terreno mais disputado
A operação cria uma situação incomum para a Nvidia. OpenAI e Anthropic estão entre seus grandes clientes de chips, mas também desenvolvem modelos que podem disputar mercado com o Nemotron.
A empresa trabalha agora na versão mais avançada do projeto, que pode superar 1 trilhão de parâmetros. Alguns modelos chineses, segundo o texto, já são maiores.
Com a Poolside, a Nvidia deixa de atuar apenas nos bastidores da corrida da IA. A companhia passa a disputar também o desenvolvimento dos modelos que dependem de seus próprios processadores.
A Alibaba lançou nesta segunda-feira (24) o Wan3.0, novo modelo de inteligência artificial para geração de vídeos. Segundo a Reuters, a ferramenta consegue criar vídeos de até 30 segundos usando documentos, planilhas, apresentações e páginas da web como ponto de partida.
O anúncio veio um dia depois de a companhia chinesa revelar uma oferta de ações de US$ 10 bilhões (cerca de R$ 51 bilhões). A operação busca levantar recursos para os gastos crescentes com inteligência artificial.
A Alibaba lançou o Wan3.0 um dia após anunciar uma oferta de ações de US$ 10 bilhões para financiar gastos crescentes com IA. Imagem: BigTunaOnline/Shutterstock
Wan3.0 já tem aplicações
O modelo não parte apenas de comandos de texto para criar vídeos. Documentos, planilhas, slides e páginas da internet também podem servir de base para a produção.
A Alibaba Cloud apresentou o Wan3.0 em uma publicação no WeChat. A versão beta pública havia sido disponibilizada em 6 de agosto.
Desde então, a tecnologia passou a ser usada em diferentes atividades. A lista inclui produção de dramas curtos e filmes, publicidade, marketing, promoção turística e criação de videoclipes.
Empresa aumenta aposta em IA
A chegada do Wan3.0 ocorre enquanto a Alibaba eleva os investimentos no setor. No domingo, a empresa anunciou uma oferta de ações de US$ 10 bilhões, considerada a maior oferta primária de novas ações já feita por uma companhia listada em Hong Kong.
A captação acontece em meio à disputa cada vez mais acirrada pelo desenvolvimento de tecnologias de inteligência artificial. Para a Alibaba, a expansão nessa área vem acompanhada de despesas cada vez maiores.
Entre os principais pontos do novo modelo estão:
Vídeos de até 30 segundos;
Uso de documentos como fonte para a criação;
Suporte a planilhas, slides e páginas da web;
Aplicações em filmes, dramas curtos e videoclipes;
Uso em publicidade, marketing e promoção turística.
A aposta em IA tem custo alto para a Alibaba: o lucro trimestral da empresa caiu 75% em meio ao aumento das despesas com a tecnologia. – Imagem: DC Studio/Shutterstock
Gastos pesam no balanço
O aumento dos investimentos já aparece nos resultados da Alibaba. Na semana passada, a companhia informou uma queda de 75% no lucro trimestral em relação ao mesmo período do ano anterior.
Segundo a Reuters, o recuo ocorreu em meio ao avanço das despesas de capital ligadas à inteligência artificial. A nova captação de recursos acontece justamente nesse momento.
Com o Wan3.0, a Alibaba coloca mais uma ferramenta de geração de vídeo no mercado enquanto direciona bilhões de dólares para ampliar sua atuação em inteligência artificial.