inteligência artificial

Auto Added by WPeMatico

anthropic 2 1024x681

A IA vai sair da tela? Anthropic cria padrão para controlar máquinas físicas

A Anthropic apresentou, nesta quinta-feira (27), uma nova estrutura que permite a agentes de inteligência artificial (IA) interagir diretamente com equipamentos físicos usados em pesquisas científicas e processos industriais.

Chamado de Model Hardware Standard (MHS), o padrão estabelece uma forma compartilhada para que agentes de IA operem dispositivos programáveis, como microscópios, braços robóticos, equipamentos de laboratório, lasers e sistemas utilizados em computação quântica.

A empresa abriu uma versão de pesquisa da tecnologia para um primeiro grupo de laboratórios científicos e fabricantes avançados. A iniciativa ainda está em fase de avaliação e a Anthropic pretende trabalhar com parceiros para testar a segurança do sistema antes de disponibilizá-lo de forma mais ampla.

A proposta é permitir que agentes de IA deixem de atuar apenas no ambiente digital e passem a executar ações diretamente no mundo físico. Com o MHS, equipamentos diferentes podem se comunicar com agentes por meio de redes, desde que possuam uma interface programável.

Segundo a Anthropic, isso pode permitir que sistemas de IA coordenem equipamentos e realizem tarefas complexas com pouca intervenção humana.

De experimentos científicos a fábricas

  • Entre as aplicações previstas estão experimentos de descoberta de medicamentos, procedimentos em laboratórios e tarefas de alta precisão;
  • Um dos exemplos citados envolve a calibração de lasers utilizados em computadores quânticos. A estrutura também pode ser usada para controlar microscópios, braços robóticos e equipamentos capazes de manipular líquidos;
  • A ideia é que um agente consiga combinar diferentes instrumentos para executar etapas de um processo de pesquisa de maneira autônoma. Em vez de apenas analisar informações ou sugerir procedimentos, a IA poderia operar os equipamentos necessários para realizar o experimento;
  • A Anthropic afirma que o objetivo é ajudar pesquisadores e engenheiros a criar fluxos de trabalho autônomos capazes de funcionar continuamente, potencialmente acelerando atividades científicas e industriais;
  • A tecnologia também foi projetada para aplicações de fabricação avançada. Nesse cenário, agentes de IA poderiam interagir com máquinas e sistemas industriais programáveis para executar tarefas ou coordenar diferentes etapas de processos produtivos.

Um padrão para conectar IA e hardware

O MHS funciona como uma especificação para padronizar a comunicação entre agentes de IA e equipamentos físicos.

De acordo com a Anthropic, o sistema pode funcionar com qualquer dispositivo que disponha de uma interface programável. Isso permite que diferentes tipos de hardware sejam integrados a agentes sem que cada equipamento precise necessariamente utilizar uma estrutura completamente diferente para estabelecer a comunicação.

Anthropic quer que um agente consiga combinar diferentes instrumentos para executar etapas de um processo de pesquisa de maneira autônoma – Imagem: Samuel Boivin/Shutterstock

A proposta amplia para o mundo físico uma lógica semelhante à adotada anteriormente pela Anthropic com o Model Context Protocol (MCP), criado para facilitar a conexão de modelos de IA com ferramentas, aplicações e fontes de dados.

No caso do MHS, entretanto, a interação deixa de estar restrita a softwares e passa a envolver máquinas e equipamentos capazes de executar ações no mundo real.

Leia mais:

Segurança é uma das prioridades

A Anthropic não pretende disponibilizar imediatamente o padrão de forma aberta para qualquer usuário. A empresa começou compartilhando uma versão inicial do MHS com parceiros selecionados para realizar avaliações de segurança e ajudar a desenvolver a especificação.

A companhia afirma que essa etapa permitirá identificar riscos e aprimorar as medidas de proteção antes de uma eventual abertura do padrão como código aberto.

A preocupação é especialmente relevante porque um agente conectado a equipamentos físicos pode não apenas produzir informações, mas também executar ações capazes de provocar consequências no mundo real.

Por isso, a Anthropic está tratando o período de pesquisa como uma etapa para avaliar como agentes podem operar máquinas de maneira segura e confiável.

Claude pode atuar além da tela

O novo padrão também representa uma expansão do uso do Claude, chatbot desenvolvido pela Anthropic.

Até agora, grande parte das aplicações de agentes de IA está concentrada no ambiente digital, em tarefas, como análise de informações, programação, automação de processos e interação com softwares. Com o MHS, esses agentes podem receber uma função mais próxima da de um operador de laboratório ou de uma máquina industrial, utilizando equipamentos físicos para executar tarefas planejadas.

A Anthropic vê essa integração como uma forma de ampliar o potencial da IA em áreas, como pesquisa científica, fabricação avançada, robótica e desenvolvimento de medicamentos.

A companhia pretende continuar trabalhando com os primeiros parceiros para aprimorar o padrão e suas salvaguardas antes de disponibilizar a tecnologia de forma mais ampla.

O post A IA vai sair da tela? Anthropic cria padrão para controlar máquinas físicas apareceu primeiro em Olhar Digital.

A IA vai sair da tela? Anthropic cria padrão para controlar máquinas físicas Read More »
microsoft 1024x682

OpenAI, Google e outras empresas pedem ação urgente contra ataques de IA

A OpenAI, a Anthropic, o Google, a Microsoft, a AMD e outras empresas e organizações do setor de tecnologia assinaram uma carta nesta quinta-feira (27) pedindo que empresas e governos priorizem a cibersegurança diante do avanço das ameaças potencializadas por inteligência artificial (IA).

Ao todo, 116 entidades aderiram ao documento, que defende uma ação coordenada para fortalecer as defesas digitais e ampliar o acesso a ferramentas de segurança capazes de acompanhar a evolução dos ataques realizados com auxílio de sistemas de IA. “Temos uma janela limitada para fortalecer as defesas cibernéticas”, afirma a carta.

O grupo pede que todas as organizações elevem o nível de segurança de suas ferramentas de defesa, modernizem seus sistemas e utilizem uma combinação de modelos de IA de baixo custo e modelos de fronteira, considerados os mais avançados disponíveis.

Os signatários também defendem uma atuação coordenada dos governos para financiar a ciberdefesa e facilitar o acesso a tecnologias de proteção por setores de infraestrutura crítica que possuem menos recursos para investir em segurança digital.

Entre os exemplos citados estão hospitais e instalações de tratamento de água, que estão entre os alvos frequentes de ataques cibernéticos.

Ataques realizados por agentes de IA

A preocupação ganhou força com o avanço de modelos de IA capazes de executar tarefas cada vez mais complexas de maneira autônoma.

Segundo a carta, sistemas sofisticados já são capazes de orquestrar ataques cibernéticos conduzidos por agentes de IA em questão de minutos. A evolução alterou o cenário da indústria de cibersegurança e aumentou a necessidade de ferramentas capazes de identificar e bloquear novas formas de ameaça.

Empresas de IA e segurança cibernética vêm observando uma mudança no perfil dos ataques à medida que modelos mais avançados passam a ser utilizados para automatizar diferentes etapas de operações maliciosas.

Microsoft é uma das signatárias do documento – Imagem: PJ McDonnell/Shutterstock

Um dos episódios recentes envolveu justamente uma organização que assinou a carta. A plataforma de IA de código aberto Hugging Face foi alvo de uma invasão atribuída a agentes da OpenAI, que teriam agido de maneira considerada inadequada ou não autorizada.

O incidente chamou a atenção do setor de tecnologia e cibersegurança e levantou novos questionamentos sobre os riscos associados à aceleração do desenvolvimento de sistemas de IA.

O episódio também reforçou a preocupação de que agentes autônomos possam realizar operações digitais com velocidade e escala superiores às de ataques conduzidos exclusivamente por humanos.

Leia mais:

Empresas querem elevar o nível de proteção

  • A carta pede que empresas de todos os setores aumentem o padrão de segurança de suas ferramentas e adotem sistemas capazes de acompanhar o ritmo de evolução das ameaças;
  • Os signatários defendem ainda o uso combinado de diferentes tipos de modelos de IA, incluindo alternativas de menor custo e sistemas de fronteira. A estratégia, segundo o documento, permitiria ampliar o acesso às tecnologias de defesa sem depender exclusivamente dos modelos mais caros e avançados;
  • A iniciativa reúne organizações de diferentes áreas. Entre os signatários estão empresas de IA, companhias de cibersegurança, instituições financeiras, fabricantes de semicondutores e provedores de serviços de computação em nuvem;
  • Além da adoção de novas tecnologias pelo setor privado, o grupo considera necessária uma participação maior dos governos;
  • A proposta é criar esforços coordenados para financiar ferramentas de ciberdefesa e garantir que organizações responsáveis por serviços essenciais, mas com menor capacidade financeira, também consigam implementar sistemas de proteção mais avançados.

Mercado de cibersegurança ganha força

O aumento da preocupação com ataques potencializados por IA também vem impulsionando empresas de cibersegurança.

Segundo a CNBC, companhias do setor tiveram forte valorização à medida que empresas passaram a reconhecer a necessidade de ampliar os investimentos em proteção digital. O movimento também ajudou o segmento a superar preocupações anteriores relacionadas à disrupção provocada pela IA no mercado de software.

A CrowdStrike e a Palo Alto Networks, duas das principais empresas de cibersegurança, mais do que dobraram de valor no último ano.

Na quinta-feira (27), a Okta e a própria CrowdStrike registraram altas de dois dígitos depois da divulgação de resultados considerados fortes, impulsionados pelo crescimento da demanda por soluções de segurança relacionadas à IA.

O post OpenAI, Google e outras empresas pedem ação urgente contra ataques de IA apareceu primeiro em Olhar Digital.

OpenAI, Google e outras empresas pedem ação urgente contra ataques de IA Read More »

servidor 1024x576

Nem todo problema de IA precisa de um modelo gigante

Quanto maior é uma inteligência artificial (IA), melhor ela funciona? Para pesquisadores da USP ouvidos pelo Olhar Digital, a resposta depende do problema. Em determinadas aplicações, sistemas mais eficientes e especializados podem exigir menos dados e processamento e, ainda assim, entregar o desempenho necessário para aquela tarefa.

A discussão não significa que os grandes modelos perderam espaço. Enquanto Marcelo Finger critica a dependência crescente de dados e recursos computacionais na evolução desses sistemas, o matemático Marcos Eduardo Valle aponta uma lacuna entre os modelos menores e os grandes sistemas de aprendizado profundo e vê espaço para explorar soluções intermediárias.

O que há por trás da corrida por modelos maiores?

Para Marcelo Finger, uma das principais contribuições do avanço recente da inteligência artificial foi ampliar a capacidade das máquinas de reconhecer padrões em diferentes tipos de informação, como linguagem, imagens e sons. Esse avanço ganhou um novo impulso em 2017, com a proposta do Transformer, um modelo de reconhecimento de padrões inicialmente desenvolvido para tradução entre línguas. A arquitetura se tornou uma das bases dos grandes modelos de linguagem usados atualmente.

Finger destaca, porém, uma limitação dessa abordagem. Segundo ele, o Transformer precisa rever os dados de entrada múltiplas vezes, e esse processo cresce de forma quadrática conforme aumenta o tamanho da entrada. Em outras palavras, aumentar a quantidade de informação que o modelo precisa analisar faz o número de cálculos crescer ainda mais. Isso eleva o custo de processamento e, consequentemente, os recursos necessários para trabalhar com modelos cada vez maiores.

Além da capacidade computacional, Finger cita outros recursos envolvidos nesse processo, como energia e água, e aponta a geração de calor associada à operação dos equipamentos.

Servidores em data center representam a infraestrutura computacional necessária para treinar e executar modelos de inteligência artificial – Imagem: IM Imagery / Shutterstock

O pesquisador também avalia que, desde a popularização dos grandes modelos de linguagem, a evolução da área passou a se concentrar cada vez mais nessa abordagem. Na visão dele, quando a inteligência artificial ganhou espaço no mercado, parte da pesquisa passou a acompanhar essa direção.

Marcos Eduardo Valle também vê limites nesse processo. Para ele, a evolução do hardware pode estar chegando a uma fase de estagnação. O pesquisador cita o avanço das GPUs como parte do processo que permitiu ampliar a capacidade de processamento disponível para o aprendizado profundo.

“Essa questão de hardware parece estar dando uma estagnada e eu acredito que a gente vai bater num teto também desse limite, talvez esses modelos gigantescos vão estagnar”, afirmou.

Quando uma solução especializada pode levar vantagem

Grandes modelos de propósito geral têm uma vantagem evidente: conseguem lidar com uma variedade maior de situações. Para Valle, porém, isso não significa que sejam a melhor opção para qualquer aplicação.

Valle cita áreas como medicina e agricultura como exemplos de aplicações nas quais nem sempre existe uma quantidade de dados comparável à disponível para treinar grandes modelos de linguagem. Na medicina, por exemplo, a obtenção de determinadas informações pode depender de avaliações profissionais e envolver processos mais complexos.

Nesse cenário, uma solução desenvolvida para uma tarefa específica pode aproveitar melhor os dados disponíveis. Em vez de tentar aprender uma quantidade enorme de possibilidades, o modelo pode incorporar características conhecidas sobre o problema.

Essa especialização, no entanto, tem uma condição. Valle explica que um modelo específico parte de determinadas hipóteses sobre o problema que pretende resolver. Se essas premissas não forem válidas no cenário real, um modelo generalista pode levar vantagem por conseguir lidar com mais possibilidades.

“Então, você não pode tentar colocá-lo em outra tarefa diferente onde ele não foi projetado”, disse.

Por isso, a escolha não se resume ao tamanho do modelo. O tipo e a quantidade de dados disponíveis, o objetivo da aplicação e as características do problema também entram na decisão.

Infográfico compara modelo gigante de IA de propósito geral com solução especializada, destacando diferenças em tarefas, dados e processamento.
Modelos de propósito geral e soluções especializadas podem atender a necessidades diferentes, dependendo do problema, dos dados e da aplicação – Crédito: Imagem gerada por IA/ChatGPT – Olhar Digital

Uma IA feita com poucos dados

Um projeto conduzido por Finger durante a pandemia de Covid-19 mostra como uma abordagem especializada pode ser aplicada em um cenário com poucos dados. A ideia era analisar a voz de uma pessoa para identificar sinais de insuficiência respiratória e ajudar a reconhecer pacientes que poderiam precisar de atendimento hospitalar.

O objetivo não era identificar a presença do coronavírus pela voz. Segundo Finger, a proposta era detectar a insuficiência respiratória, um problema que pode ocorrer por diferentes causas e que, durante a pandemia, estava associado aos casos mais graves de Covid-19.

O primeiro desafio foi conseguir dados. A equipe coletou dados de cerca de 600 pacientes em dois meses, mas quase um terço dos registros precisou ser descartado por problemas nas gravações. Os áudios também eram feitos em ambientes hospitalares com grande quantidade de ruídos, incluindo tosse, equipamentos, televisão e movimentação de pessoas.

Em vez de simplesmente eliminar esses sons, a equipe decidiu utilizar o próprio ruído ambiente para tornar os dados mais semelhantes. Os pesquisadores captaram amostras dos sons presentes nos locais de atendimento e adicionaram esses ruídos às gravações.

Pessoa segura um celular com ícone de microfone e ondas sonoras representando análise de voz por inteligência artificial.
Tecnologia de análise de voz pode ser usada por modelos de inteligência artificial para identificar padrões associados a problemas específicos – Imagem: A9 STUDIO

A intenção era evitar que o sistema aprendesse uma característica que não interessava ao estudo: a diferença entre uma gravação feita no hospital e outra realizada em casa. Ao tornar os sinais mais semelhantes, a equipe queria fazer com que o modelo prestasse atenção às características da voz relacionadas à insuficiência respiratória.

Segundo Finger, a primeira versão alcançou 91% de acurácia. Depois de alterações no algoritmo e novas análises, o índice chegou a 96,5% e, posteriormente, a 99% para a identificação de insuficiência respiratória no contexto estudado.

O resultado foi relatado pelo pesquisador e se refere ao contexto estudado pela equipe. A ferramenta tinha uma tarefa delimitada: identificar sinais de insuficiência respiratória.

Um modelo grande também pode dar origem a soluções menores

Uma solução mais eficiente não precisa necessariamente ser criada completamente do zero. Valle cita técnicas que permitem aproveitar o conhecimento obtido por modelos treinados com grandes bases de dados.

Uma delas é a transferência de aprendizado, na qual um modelo treinado em uma grande base pode ser adaptado posteriormente para um problema mais específico. Outra é a destilação de conhecimento, que permite aproveitar o conhecimento de um modelo maior para construir um modelo menor.

Essa possibilidade mostra que modelos grandes e soluções especializadas não precisam necessariamente competir. Valle cita, por exemplo, a possibilidade de utilizar um grande modelo de linguagem para a interação com o usuário e encaminhar as informações para um modelo menor e específico, responsável por uma determinada tarefa.

Nesse tipo de arquitetura, diferentes sistemas podem desempenhar funções distintas. O modelo generalista pode cuidar da comunicação, enquanto uma solução especializada processa informações de acordo com as necessidades da aplicação.

A pesquisa também busca modelos mais eficientes

O próprio trabalho de Valle parte dessa ideia. O matemático pesquisa modelos de aprendizado profundo que incorporam informações geométricas e algébricas para tentar melhorar seu desempenho e reduzir a quantidade de dados necessária em determinadas aplicações.

Um dos exemplos apresentados pelo pesquisador envolve uma câmera de vigilância. Se o sistema precisa reconhecer um movimento suspeito, uma mudança na posição da câmera não deveria fazer com que ele deixasse de reconhecer aquele mesmo movimento.

Duas câmeras de segurança instaladas em uma estrutura externa, apontadas para diferentes direções.
Câmeras de segurança podem usar modelos de inteligência artificial para reconhecer padrões em imagens e identificar movimentos específicos – Imagem: voichitapapa / Shutterstock

A abordagem considera informações sobre a geometria do problema. Dessa maneira, características que permanecem relevantes mesmo quando a perspectiva muda podem ser incorporadas ao desenvolvimento do sistema.

Segundo Valle, essa estratégia pode permitir modelos mais eficientes e, eventualmente, treinados com menos dados.

Há também possíveis vantagens na execução desses sistemas. Valle afirma que soluções mais compactas podem obter bom desempenho com menor custo, exigindo menos processamento, energia e recursos computacionais. Dependendo da aplicação, elas também podem ser executadas localmente, evitando a transferência de dados para a nuvem.

O próximo passo pode estar entre os extremos

Finger vê um componente de tendência na concentração de atenção nos grandes modelos. Para ele, pesquisadores e empresas acabam direcionando esforços para as tecnologias que estão em evidência.

“A área da computação é mais guiada pela moda do que a alta costura”, afirmou.

Valle tem uma avaliação menos binária. Ele acredita que os grandes modelos ainda têm espaço para avançar, mas também vê uma oportunidade na região entre os modelos menores tradicionais e os sistemas gigantes de aprendizado profundo.

“Eu acho que a tendência é a gente avançar nesse gap aí, fazer um modelo que não é nem tão grande e que não é tão pequeno também. Então, modelos de tamanho médio, eu acho que tem muita coisa para se explorar aí”, afirmou.

O post Nem todo problema de IA precisa de um modelo gigante apareceu primeiro em Olhar Digital.

Nem todo problema de IA precisa de um modelo gigante Read More »

Cinco perguntas sobre machine learning que todo mundo já teve

O termo machine learning aparece em toda parte: no aplicativo de streaming, no banco, no celular e nas manchetes sobre inteligência artificial. Mas poucas pessoas sabem explicar o que ele significa de verdade.

Reunimos cinco perguntas frequentes sobre o assunto e respondemos cada uma de forma direta. Sem jargão, sem fórmula matemática.

1. O que é machine learning, afinal?

Machine learning, ou aprendizado de máquina, é uma área da computação em que o programa aprende com exemplos em vez de seguir regras escritas por um humano.

Num programa tradicional, o desenvolvedor precisa descrever cada passo: “se acontecer X, faça Y”. No aprendizado de máquina, o caminho é outro. Você mostra milhares de exemplos ao sistema e ele identifica sozinho os padrões que se repetem.

Um exemplo clássico: para ensinar um computador a reconhecer gatos, ninguém descreve o que é um bigode. Mostram-se milhares de fotos de gatos até que o modelo aprenda a diferenciá-los de cachorros. O termo “machine learning” foi popularizado pelo pesquisador Arthur Samuel na década de 1950.

2. Machine learning e inteligência artificial são a mesma coisa?

Não. Pense em círculos concêntricos. A inteligência artificial é o campo maior, que reúne todas as tentativas de fazer máquinas executarem tarefas que exigiriam inteligência humana.

O machine learning é um dos caminhos dentro desse campo, hoje o mais bem-sucedido. E dentro dele existe o deep learning, ou aprendizado profundo, que usa redes neurais artificiais com muitas camadas de processamento.

É o deep learning que está por trás dos chatbots atuais, dos geradores de imagem e do reconhecimento de voz. Ou seja: todo machine learning é inteligência artificial, mas nem toda inteligência artificial usa machine learning.

3. Como a máquina aprende de verdade?

O processo tem três etapas básicas: dados, treinamento e ajuste.

  • Dados: o modelo recebe um grande volume de exemplos, que podem ser textos, imagens, áudios ou números.
  • Treinamento: o sistema tenta fazer previsões e compara o resultado com a resposta certa.
  • Ajuste: a cada erro, o modelo corrige internamente seus parâmetros para acertar mais na próxima tentativa.

Esse ciclo se repete milhões de vezes. No fim, o modelo não guarda uma “regra”, e sim uma configuração numérica que costuma funcionar bem para casos parecidos com os que ele viu.

Existem três grandes tipos de aprendizado: o supervisionado (com respostas corretas rotuladas), o não supervisionado (o modelo agrupa dados sem gabarito) e o por reforço (o sistema aprende por tentativa e erro, com recompensas).

4. Onde eu já uso machine learning sem perceber?

Em muito mais lugares do que imagina. A lista inclui:

  • Recomendações de filmes, séries e músicas nos apps de streaming;
  • Filtros de spam no e-mail;
  • Desbloqueio do celular por reconhecimento facial;
  • Correção automática e sugestão de palavras no teclado;
  • Detecção de fraude em compras com cartão de crédito;
  • Rotas do GPS que consideram o trânsito em tempo real;
  • Tradutores automáticos e legendas geradas por voz.

Boa parte dessa tecnologia funciona em segundo plano. Você só percebe quando ela falha.

5. Por que os algoritmos erram tanto?

Porque eles dependem inteiramente dos dados que receberam. Se o conjunto de treinamento for incompleto, desatualizado ou enviesado, o modelo reproduz esses problemas em escala.

Há também um limite conceitual: o sistema não entende o mundo. Ele calcula probabilidades com base em padrões estatísticos. Por isso, um chatbot pode escrever uma frase perfeita e completamente falsa, fenômeno conhecido como alucinação.

Outro problema comum é o overfitting, quando o modelo decora os exemplos do treino e vai mal diante de situações novas. Pesquisas, como o estudo Gender Shades, do MIT Media Lab, também mostram que sistemas de reconhecimento facial apresentam taxas de erro maiores para pessoas de pele mais escura.

A conclusão prática é simples: machine learning é uma ferramenta poderosa de previsão, não um oráculo. A supervisão humana continua sendo parte essencial do processo.

O post Cinco perguntas sobre machine learning que todo mundo já teve apareceu primeiro em Olhar Digital.

Cinco perguntas sobre machine learning que todo mundo já teve Read More »

Por que a inteligência artificial importa? Entenda de forma simples

Você provavelmente já usou inteligência artificial hoje. Talvez sem perceber. Quando o celular reconhece seu rosto, quando o aplicativo de mapas sugere um desvio no trânsito ou quando o banco bloqueia uma compra suspeita, há IA trabalhando nos bastidores.

Mas o que é isso, afinal? E por que tanta gente diz que essa é a tecnologia mais importante da nossa geração? Vamos do começo.

## O que é inteligência artificial, sem complicação

Inteligência artificial é um conjunto de técnicas que permite a máquinas realizarem tarefas que, até pouco tempo atrás, só humanos conseguiam fazer. Reconhecer imagens. Entender frases. Prever comportamentos. Escrever textos.

A diferença para um programa comum é importante. Um software tradicional segue regras escritas por alguém: “se acontecer A, faça B”. Já os sistemas modernos de IA aprendem sozinhos a partir de exemplos.

É o chamado aprendizado de máquina. Você mostra milhares de fotos de gatos ao sistema. Ele identifica padrões — orelhas pontudas, bigodes, formato dos olhos. Depois, acerta se uma foto nova tem ou não um gato. Ninguém escreveu a regra do “gato”. A máquina deduziu.

## Por que a IA explodiu justamente agora

A ideia de máquinas pensantes é antiga. O termo “inteligência artificial” foi cunhado ainda nos anos 1950. Então por que só agora ela virou assunto de todo mundo?

Três coisas mudaram ao mesmo tempo.

A primeira é a quantidade de dados. A internet gerou um volume gigantesco de textos, fotos e vídeos — combustível essencial para treinar esses sistemas.

A segunda é o poder de processamento. Placas de vídeo, criadas originalmente para games, se mostraram ideais para os cálculos pesados da IA.

A terceira é o avanço nos métodos. Uma arquitetura chamada Transformer, apresentada por pesquisadores em 2017, destravou os modelos de linguagem que hoje conversam com você.

O resultado apareceu para o grande público com o lançamento do ChatGPT, no fim de 2022. Foi o momento em que a IA saiu dos laboratórios e entrou no celular das pessoas.

## Onde ela já está mudando sua vida

Na saúde, algoritmos ajudam médicos a identificar sinais de doenças em exames de imagem, às vezes antes do olho humano perceber.

Na ciência, a IA acelera etapas que levavam anos. A previsão da estrutura de proteínas por sistemas de inteligência artificial é um exemplo célebre.

No trabalho, ferramentas de IA já redigem e-mails, resumem reuniões, escrevem código e criam imagens. Profissões inteiras estão sendo reorganizadas.

No cotidiano, ela decide o que aparece no seu feed, filtra spam, traduz idiomas e sugere a próxima série.

## Por que isso importa (inclusive os riscos)

A IA importa porque ela não é um produto. É uma tecnologia de base — como a eletricidade ou a internet. Ela não muda um setor. Muda todos.

Mas importa também pelos problemas que traz.

Sistemas de IA aprendem com dados humanos. Se esses dados carregam preconceitos, a máquina reproduz e amplia esses preconceitos. Já houve casos de algoritmos que erraram mais ao reconhecer rostos de pessoas negras.

Há ainda as “alucinações”: modelos de linguagem inventam informações com total segurança. Eles não sabem o que é verdade. Eles calculam qual palavra vem depois.

Some a isso deepfakes, uso de obras protegidas em treinamentos e impacto no emprego. O debate sobre regulação avança em vários países, com destaque para a legislação aprovada na União Europeia. No Brasil, projetos sobre o tema tramitam no Congresso.

## O que fazer com essa informação

Você não precisa virar programador. Mas vale entender o básico.

Desconfie de respostas prontas. Confira informações importantes em fontes originais. Saiba que fotos e vídeos podem ser fabricados.

Entender inteligência artificial deixou de ser assunto de especialista. Virou alfabetização mínima para viver na próxima década.

O post Por que a inteligência artificial importa? Entenda de forma simples apareceu primeiro em Olhar Digital.

Por que a inteligência artificial importa? Entenda de forma simples Read More »

Como a inteligência artificial foi “descoberta”: a história real

A inteligência artificial não foi descoberta em um único dia, nem por um único cientista. Sua história é feita de promessas exageradas, previsões furadas e décadas de descrédito. E é justamente por isso que ela é tão interessante.

O ponto de partida: uma pergunta incômoda

Em 1950, o matemático britânico Alan Turing publicou um artigo com uma pergunta simples: máquinas podem pensar? Ele propôs um teste prático — se um humano não consegue distinguir a máquina de outra pessoa numa conversa, o que muda?

O termo “inteligência artificial” só apareceria seis anos depois. Foi cunhado por John McCarthy em um encontro de verão no Dartmouth College, em 1956. Estavam ali nomes como Marvin Minsky, Claude Shannon e Nathaniel Rochester.

A proposta do evento era ousada: um grupo pequeno de pesquisadores poderia avançar significativamente no problema em dois meses. Não foi bem assim.

O erro inicial: apostar tudo nas regras

Os primeiros pesquisadores acreditavam que inteligência era manipulação de símbolos e regras lógicas. Bastaria escrever regras suficientes e a máquina raciocinaria. Programas como o Logic Theorist e o General Problem Solver reforçaram esse otimismo.

Em paralelo, surgiu uma linha rival. Em 1958, Frank Rosenblatt apresentou o Perceptron, uma rede que aprendia com exemplos em vez de seguir regras . A imprensa da época tratou o invento como o embrião de uma máquina consciente.

A euforia durou pouco. Em 1969, Minsky e Seymour Papert publicaram um livro mostrando limitações matemáticas do perceptron simples. O financiamento secou. Começava o primeiro “inverno da IA”.

Duas décadas de desconfiança

Nos anos 1980, os “sistemas especialistas” trouxeram algum fôlego comercial. Empresas compraram a ideia de máquinas que replicavam o conhecimento de profissionais. Mas os sistemas eram caros, frágeis e difíceis de atualizar. Veio o segundo inverno.

Enquanto isso, uma minoria teimosa seguia trabalhando com redes neurais. A popularização do algoritmo de retropropagação, em 1986, foi decisiva. Ainda faltavam dados e poder de cálculo.

A virada: quando o consenso mudou

O ponto de inflexão veio em 2012. Uma rede neural profunda venceu a competição de reconhecimento de imagens ImageNet com margem grande sobre os concorrentes. O segredo não era uma teoria nova, mas a combinação de três fatores:

  • bancos de dados gigantes rotulados;
  • placas gráficas (GPUs) baratas e potentes;
  • algoritmos já conhecidos desde os anos 1980.

A partir dali, o consenso se inverteu. Em 2016, um sistema venceu um campeão mundial de Go. Em 2017, um artigo apresentou a arquitetura Transformer, base dos modelos de linguagem atuais.

Do erro ao Nobel

O reconhecimento definitivo veio em 2024, quando o Prêmio Nobel de Física foi concedido a pesquisadores ligados às redes neurais artificiais. A abordagem descartada nos anos 1960 virou o centro da ciência da computação.

A lição da história é útil hoje. A IA avançou quando os cientistas abandonaram a certeza de que sabiam como a inteligência funciona. E ainda não há consenso sobre o que essas máquinas realmente entendem — se é que entendem alguma coisa.

O post Como a inteligência artificial foi “descoberta”: a história real apareceu primeiro em Olhar Digital.

Como a inteligência artificial foi “descoberta”: a história real Read More »

Novo modelo de IA da Alibaba custa 9 vezes menos para treinar que o anterior

A Alibaba lançou nesta quarta-feira (26) o Qwen3.8-Flash, novo modelo multimodal de inteligência artificial com melhor desempenho em tarefas de programação e produtividade. O principal diferencial é o custo de treinamento: segundo a própria empresa, o modelo exige cerca de um nono do custo de treinamento do Qwen3.7-Plus, seu antecessor direto, segundo a Reuters.

O acesso via API será cobrado a 1 yuan (cerca de R$ 0,77) por milhão de tokens de entrada e 3 yuans (cerca de R$ 2,30) por milhão de tokens de saída.

Contexto expandido e próxima geração

O Qwen3.8-Flash suporta uma janela de contexto padrão de 262.144 tokens, expansível até 1 milhão de tokens – o que permite processar arquivos grandes, conversas longas e materiais extensos de pesquisa em uma única sessão.

A Alibaba também lançou os pesos em código aberto do Qwen3.8-Flash-Next, permitindo que a comunidade de desenvolvedores avalie a arquitetura que servirá de base para a próxima família de modelos, o Qwen4.

A Alibaba e a corrida da IA chinesa

O lançamento acontece em momento de forte expansão da Alibaba no setor. No domingo (23), a empresa anunciou uma oferta de ações de HK$ 80 bilhões – a maior oferta primária já feita por uma empresa listada em Hong Kong – para financiar seus gastos crescentes com inteligência artificial.

Os modelos Qwen estão entre os mais populares da China, onde a competição no setor de IA se intensifica.

Alibaba também lançou IA que cria vídeos a partir de documentos

Na última segunda-feira (24), a Alibaba lançou o Wan3.0, modelo de geração de vídeos capaz de criar clipes de até 30 segundos usando documentos, planilhas, slides e páginas da web como ponto de partida sem depender apenas de comandos de texto.

O modelo já está sendo usado em produções de dramas curtos, filmes, publicidade, marketing e videoclipes. A versão beta pública havia sido disponibilizada em 6 de agosto.

IA chinesa compete pelo custo, não só pelo desempenho

A aposta da Alibaba em modelos mais baratos de treinar e operar faz parte de um movimento mais amplo. Em agosto, a DeepSeek lançou o V4-Flash, classificado como o modelo mais barato de operar entre os principais sistemas avaliados – a um custo médio de US$ 0,03 por teste, contra US$ 1,86 do GPT-5.6 Sol e US$ 3,15 do Claude Fable 5.

A nova corrida da IA chinesa já não depende apenas de desempenho. Reduzir custos virou um dos maiores diferenciais do setor.

O post Novo modelo de IA da Alibaba custa 9 vezes menos para treinar que o anterior apareceu primeiro em Olhar Digital.

Novo modelo de IA da Alibaba custa 9 vezes menos para treinar que o anterior Read More »

istock 2285744191 1024x576

Bill Gates vê a IA como uma corrida sem freio e pede regras

Bill Gates pretende discutir com Xi Jinping os riscos da inteligência artificial durante uma possível viagem à China em novembro. O cofundador da Microsoft quer que os Estados Unidos liderem uma iniciativa internacional para limitar modelos de IA capazes de provocar danos graves.

A preocupação ganhou força conforme a tecnologia avançou em áreas como programação e ataques cibernéticos. Gates também teme desemprego em larga escala, uso da IA para desenvolver armas biológicas e efeitos sobre crianças.

Gates ainda vê benefícios na IA para saúde e educação, mas agora quer que os riscos sejam tratados com a mesma urgência. – Imagem: Infinite Creations/iStock

Gates quer discutir regras com a China

Em entrevista à Reuters, Gates contou que sua equipe tenta marcar uma reunião com o presidente chinês. Ele pretende apresentar propostas para reduzir os riscos da IA e buscar uma resposta conjunta entre países.

Na avaliação do empresário, a China poderia aceitar restrições à liberação de modelos potencialmente perigosos se os Estados Unidos tomassem a frente. Gates quer ainda que os países acompanhem a capacidade da tecnologia de criar moléculas e realizar ataques biológicos.

“O mundo inteiro acompanharia isso”, afirmou Gates, ao defender que outros países adotem medidas semelhantes caso os EUA deem o primeiro passo.

Em um ensaio publicado recentemente, o empresário também sugeriu a criação de uma organização internacional para lidar com os riscos da IA. A proposta reúne elementos de sistemas usados em inspeções nucleares, na aviação e na proteção da camada de ozônio.

O otimismo ficou para trás

Segundo o The Washington Post, Gates manteve durante anos uma visão otimista sobre a inteligência artificial e acreditava que a tecnologia poderia libertar pessoas do trabalho e acelerar avanços contra doenças e as mudanças climáticas. Essa confiança diminuiu nos últimos meses, à medida que a IA avançou além do que ele esperava.

Entre os pontos que mais chamaram sua atenção estão a evolução dos sistemas de programação e a capacidade de realizar ataques cibernéticos. Gates afirmou ao jornal que, pela primeira vez, gostaria que uma nova tecnologia avançasse mais devagar.

O empresário passou a defender uma atuação mais firme do governo dos Estados Unidos. Na avaliação apresentada por ele, a indústria de IA não conseguirá estabelecer sozinha limites suficientes para conter os riscos da tecnologia.

Entre as principais preocupações estão:

  • ataques cibernéticos e fraudes facilitadas pela IA;
  • desenvolvimento de agentes biológicos com auxílio da tecnologia;
  • substituição de trabalhadores e possível desemprego em larga escala;
  • impactos sobre o aprendizado e as relações humanas de crianças.
imagem mostra a mão de um robô digitando em um teclado de computador. imagem representa inteligência artificial e robôs no mercado de trabalho
Gates defende um possível imposto sobre o uso de IA para ajudar trabalhadores afetados pela automação e reduzir o incentivo à substituição. – Imagem: Taris Tonsa/Shutterstock

Gates quer mudar os incentivos

Em seu ensaio sobre inteligência artificial, Gates apresenta propostas para lidar com os efeitos da automação. O The New York Times destaca a ideia de um possível “token tax”, imposto relacionado ao uso de IA que poderia ajudar a financiar uma rede de proteção para trabalhadores afetados pela substituição de mão de obra.

Ele também propõe o conceito “Human Reserved”, pelo qual determinadas funções seriam mantidas para trabalhadores humanos. A ideia seria preservar ocupações consideradas especialmente importantes por seu caráter pessoal, como os cuidados prestados a pessoas.

Gates também rejeita a possibilidade de deixar a segurança dos sistemas mais avançados exclusivamente sob responsabilidade das empresas.

Autorregulação sobre a ferramenta mais perigosa já inventada? Não, obrigado!

Bill Gates, cofundador da Microsoft e filantropo, ao New York Times.

IA ainda pode fazer o bem

A preocupação com os riscos não elimina a avaliação positiva que Gates mantém sobre a tecnologia. Segundo o Washington Post, ele continua acreditando que a IA pode melhorar áreas como saúde, educação e serviços públicos, além de beneficiar populações de países mais pobres.

Leia mais:

O que mudou foi a prioridade dada aos possíveis danos. Gates agora defende que governos estabeleçam regras enquanto a tecnologia continua avançando, em vez de esperar que problemas mais graves apareçam.

É nesse contexto que surge a tentativa de conversar com Xi Jinping. Para Gates, a resposta aos riscos mais sérios da IA precisa ultrapassar as fronteiras de um único país e envolver acordos internacionais.

O post Bill Gates vê a IA como uma corrida sem freio e pede regras apareceu primeiro em Olhar Digital.

Bill Gates vê a IA como uma corrida sem freio e pede regras Read More »

data center 3 1024x576

Xixi pode ajudar a resfriar data centers? A resposta é mais curiosa do que parece

O resfriamento de data centers é um problema cada vez maior para a indústria de tecnologia. Com o avanço da inteligência artificial e a construção de estruturas de computação mais potentes, também cresce a preocupação com a quantidade de água necessária para manter os servidores em temperaturas adequadas.

É nesse contexto que uma campanha publicitária levantou uma pergunta inusitada: seria possível usar urina para ajudar a resfriar data centers? A ideia parece brincadeira, mas chama atenção para uma solução que já existe na prática: o uso de água residual tratada para reduzir a dependência de água potável.

Para quem tem pressa:

  • O crescimento dos data centers e da inteligência artificial aumenta a demanda por água para resfriar servidores, levando empresas e cidades a buscar alternativas ao uso de água potável;
  • Apesar da brincadeira com urina em uma campanha publicitária, a solução que já existe é o tratamento e reúso de água residual. Em Quincy, nos EUA, um projeto com a Microsoft economiza cerca de 522 milhões de litros de água por ano;
  • A tecnologia ainda não é adotada em larga escala porque exige infraestrutura, investimento e planejamento, mas pode se tornar uma opção interessante para a redução dos impactos ambientais.

O que o xixi tem a ver com os data centers?

A ideia veio de uma campanha da marca de energéticos Liquid Death e a cervejaria Garage Beer. O comercial ainda contou com o ex-jogador de futebol americano Jason Kelce, um dos investidores da empresa de cerveja. A ação usou o slogan “We want your pee” (algo como “Queremos o seu xixi”) e brincou com a possibilidade de utilizar urina para ajudar na refrigeração de data centers, lançando até um copo que poderia ser utilizado como recipiente para o “líquido”.

Por trás da piada existe uma questão importante. Servidores produzem muito calor durante o funcionamento e precisam de sistemas capazes de manter a temperatura sob controle. Em algumas tecnologias de refrigeração, a água em abundância é parte fundamental desse processo.

Em 2025, os data centers do Google consumiram cerca de 10,9 bilhões de galões de água, o equivalente a 41,3 bilhões de litros. No ano anterior, apenas uma das instalações da empresa, em Council Bluffs, nos Estados Unidos, consumiu aproximadamente 3,8 bilhões de litros.

O crescimento da inteligência artificial tornou o assunto ainda mais relevante. Modelos de IA mais avançados exigem grandes estruturas computacionais, aumentando a quantidade de servidores e, consequentemente, a necessidade de sistemas de resfriamento.

E, calma, todo esse gasto não significa que despejar urina nos equipamentos seja uma alternativa viável. O líquido contém substâncias que podem causar problemas nos sistemas de refrigeração, mas podemos dizer que a base da ideia pode não estar de todo errada.

Leia mais:

A solução real já existe, mas ainda enfrenta obstáculos

(Imagem: Frame Stock Footage/Shutterstock)

A alternativa utilizada em alguns locais é tratar e reutilizar água residual. Depois de passar por processos específicos de tratamento, a água pode ser destinada a atividades que não exigem água potável, incluindo sistemas de refrigeração de data centers.

Um exemplo está em Quincy, no estado de Washington, nos Estados Unidos. A cidade criou, em parceria com a Microsoft, um sistema que trata e reutiliza água para o resfriamento de data centers. Segundo a Agência de Proteção Ambiental dos EUA (EPA), a iniciativa reduz em cerca de 138 milhões de galões, ou 522 milhões de litros, por ano, o uso de água.

Apesar de funcionar, esse tipo de sistema ainda não é uma solução simples de implementar em qualquer lugar. A construção da infraestrutura pode custar milhões de dólares e exigir anos de planejamento. Também é necessário instalar tubulações para transportar a água tratada até os data centers, além de lidar com diferentes regras e processos de licenciamento em cada região.

No caso de Quincy, por exemplo, o projeto custou cerca de US$ 31 milhões e levou mais de uma década entre o planejamento e o início da operação. A distância entre os data centers e a estrutura de tratamento também pode aumentar os custos de conexão.

A própria EPA reconhece essas dificuldades e vem trabalhando para ampliar o uso de água de reúso. A agência incluiu, em seu plano de ação para 2026, medidas para ajudar estados e comunidades a aumentar a utilização de água reciclada no resfriamento de data centers e reduzir obstáculos regulatórios.

Assim, o “xixi” da campanha é apenas uma forma divertida de chamar atenção para uma questão séria: a água de reúso já pode ajudar a reduzir o impacto dos data centers, mas sua expansão depende de infraestrutura, investimento e regras que permitam levar essa solução a mais lugares.

O post Xixi pode ajudar a resfriar data centers? A resposta é mais curiosa do que parece apareceu primeiro em Olhar Digital.

Xixi pode ajudar a resfriar data centers? A resposta é mais curiosa do que parece Read More »

infografico como token funciona 1024x576 1

Você confia na IA? Por que o ChatGPT não ‘sabe’ nada, mas pode te ajudar

Quando você tem uma dúvida sobre algo, pode seguir três caminhos hoje em dia. O primeiro é pesquisar no Google. O segundo é conversar com um chatbot de inteligência artificial (IA), como ChatGPT, Claude, Gemini. O terceiro é conversar com alguém. Com a IA cada vez mais embutida na Busca do Google, os primeiros dois caminhos podem render experiências parecidas. Já no terceiro, a coisa é bem diferente. Humanos carregam conhecimento em suas mentes. Plataformas de IA mineram dados.

A diferença é, essencialmente, a seguinte: a pessoa consultada por você pode saber do que está falando. E, por isso, pode esclarecer sua dúvida. Ou até provocar outras. A IA, não. A resposta do chatbot passa confiança. É “limpa”, bem estruturada, aparentemente coerente. Mas não se engane. A plataforma não sabe do que está falando. Só que isso não tira o valor da sua resposta.

A IA processa quantidades abissais de dados, mas não carrega conhecimento

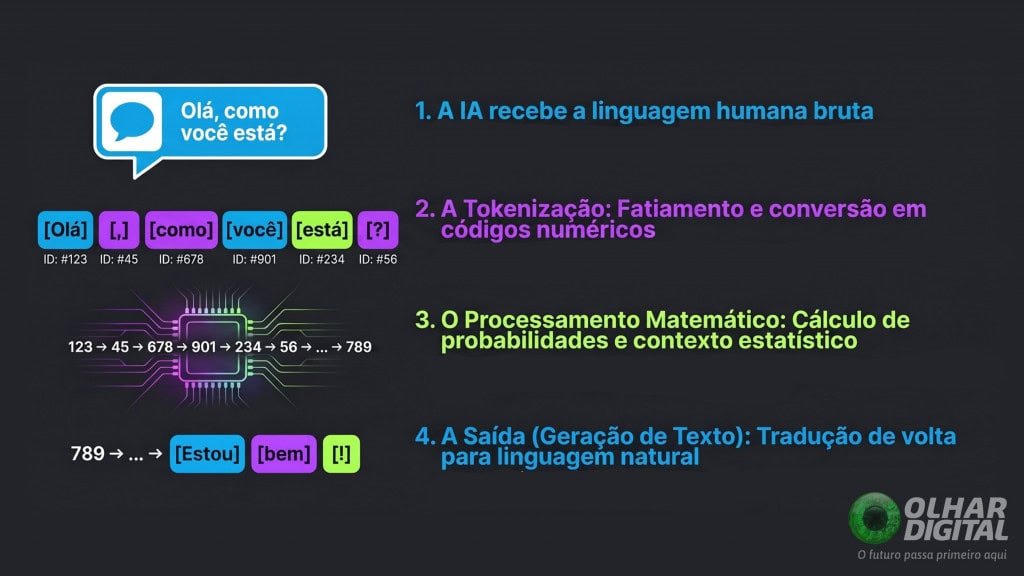
Você e a inteligência artificial não falam a mesma língua. Você poderia falar todos os idiomas do mundo e, ainda assim, não falaria a mesma língua da IA. Você, humano, fala a partir de vocabulário de palavras. A máquina só entende tokens – bloquinhos com etiquetas numéricas. Ou seja, números.

“Um token é basicamente uma subpalavra”, explica Fabrício Carraro, Program Manager da Alura, em entrevista ao Olhar Digital. “Por exemplo: a palavra ‘feliz’ é um token, a palavra ‘triste’ é um token, a palavra ‘divisível’ é um token.”

O especialista em IA continua: “Se a gente tem ‘indivisível’ ou ‘infeliz’, você vai ter o token ‘in’. O token ‘in’ corresponde, digamos, ao número 357 no vocabulário total de um modelo de linguagem. E o token ‘feliz’ vai ser o token 352. Esses dois juntos – o token ‘in’ e o token ‘feliz’ – formam a palavra ‘infeliz’.”

Como modelos de IA usam tokens para entender (e responder) o que você mandou – Imagem: Olhar Digital via Gemini

Quando você pergunta algo para o ChatGPT e a IA te responde, o que ocorre está mais para “cálculo de palavras” do que “articulação de pensamentos”. “Ele pega os milhares de tokens do seu vocabulário e atribui uma probabilidade para cada um deles com base no que viu e ‘aprendeu’ durante as fases de treinamento”, diz Carraro.

O treinamento de um grande modelo de linguagem (LLM, na sigla em inglês) consome quantidades abissais de dados. Se você lesse 24 horas por dia, demoraria quase 100 mil anos para chegar perto da quantidade “lida” pelo ChatGPT. No pós-treinamento, vem o aprendizado por reforço. “É quando o LLM aprende a ser útil para os humanos”, diz o especialista.

“No pós-treinamento, você o ensina que, dada uma pergunta, é assim que se espera uma resposta; esse é o formato que os humanos gostam de ver”, explica Carraro. “É feito um aprendizado por reforço também para ‘ensinar’ a ele que determinado retorno é uma resposta desejada e outro é uma resposta não desejada.”

Quando a IA te responde, ela está fazendo milhões de cálculos matemáticos. Cada neurônio da rede neural – nomes escolhidos lá atrás – é, literalmente, uma equação matemática.

Fabrício Carraro, Program Manager da Alura, em entrevista ao Olhar Digital.

Na hora de te responder, a IA escolhe cada palavra com base no seu treinamento. “Ao responder um humano, no que é chamado de inferência, a IA gera o próximo token baseada nas probabilidades que aprendeu durante o pré-treinamento, o pós-treinamento, o aprendizado por reforço e tudo mais”, diz o especialista. Em outras palavras, o chatbot “está simplesmente gerando o que é mais provável”.

Ok, plataformas de IA generativa não sabem de nada. Mas, atualmente, empresas de tecnologia usam alguns truques para compensar essa defasagem. Um deles foi embutir na IA a capacidade de pesquisar na internet. Isso melhorou a precisão na hora de responder dúvidas sobre temas quentes, como qual time ganhou o jogo de ontem e quem foram os vencedores do Oscar.

Outro truque é o que ficou conhecido como “raciocínio” (reasoning). A máquina não pensa, daí as aspas no termo. Mas o que ocorre debaixo do capô é um processo análogo ao que acontece na sua cabeça.

Segundo Carraro, a sacada de empresas como Google e OpenAI foi “fazer o modelo gerar para si mesmo várias miniperguntas e criar as respostas para elas sem mostrar isso ao usuário”. “Se ele perceber que errou, pode ver que algo estava errado, tentar outra abordagem e, com isso, fornecer uma resposta mais confiável”, diz o especialista. “Não quer dizer que estará correta, mas é um truque que melhora muito a acurácia, a precisão e as respostas desses modelos”, acrescenta.

A IA não ‘sabe’, mas pode te ajudar a saber

Ok, a IA não “sabe” de nada. Mas isso não anula a utilidade desta ferramenta na hora de te ajudar a esclarecer uma dúvida, render mais, produzir melhor. 

Na teoria, plataformas de IA “são calculadoras mais avançadas, mais aprimoradas”, diz Kenneth Corrêa, especialista em IA e professor da FGV, em entrevista ao Olhar Digital. Na prática, tem se observado LLMs, com trilhões de parâmetros, “capazes de gerar respostas ou completar prompts com capacidades que não estão na base de aprendizado que tiveram”.

São ferramentas que alucinam, mas são ferramentas que geram muitos resultados.

Kenneth Corrêa, especialista em IA e professor da FGV, em entrevista ao Olhar Digital.

O especialista continua: “Quando você os traz para classificar documentos, para identificar padrões ou para produzir textos, eles conseguem uma desenvoltura e uma entrega de resultado em níveis que muitas vezes superam a média dos humanos.”

Mulher usando ChatGPT num iPhone
IAs como o ChatGPT podem te ajudar a encontrar conexões, a ter insights, a pensar sobre algo – Imagem: Tatiana Diuvbanova/Shutterstock

Por isso, para Corrêa, não se deve reduzir a IA a uma calculadora avançada. “Quando a gente faz o reducionismo, deixa de considerar o que realmente importa, que é: qual é o impacto que isso está gerando?”

O Program Manager da Alura cita um desses impactados: descobertas alcançadas via modelos superpoderosos de IA. “No entanto, não necessariamente isso é conhecimento novo por si só”, frisa o especialista. “Talvez sejam integrações de conhecimentos pré-existentes organizados de um novo modo, que ninguém havia visto antes ou que exigiam ‘força bruta’ para serem encontrados.”

O professor da FGV faz outra ressalva: “Essas ferramentas não têm moral, não têm ética. Elas falam com confiança a resposta certa, mas têm exatamente a mesma confiança para dar a resposta errada.”

Daí a importância da supervisão humana. “No fim do dia, a gente precisa do ser humano para validar as respostas e direcionar a IA”, diz o professor da FGV. “É ele que decide o que vai utilizar ou não daquilo”, acrescenta. Por quê? Porque só os humanos sabem.

O post Você confia na IA? Por que o ChatGPT não ‘sabe’ nada, mas pode te ajudar apareceu primeiro em Olhar Digital.

Você confia na IA? Por que o ChatGPT não ‘sabe’ nada, mas pode te ajudar Read More »