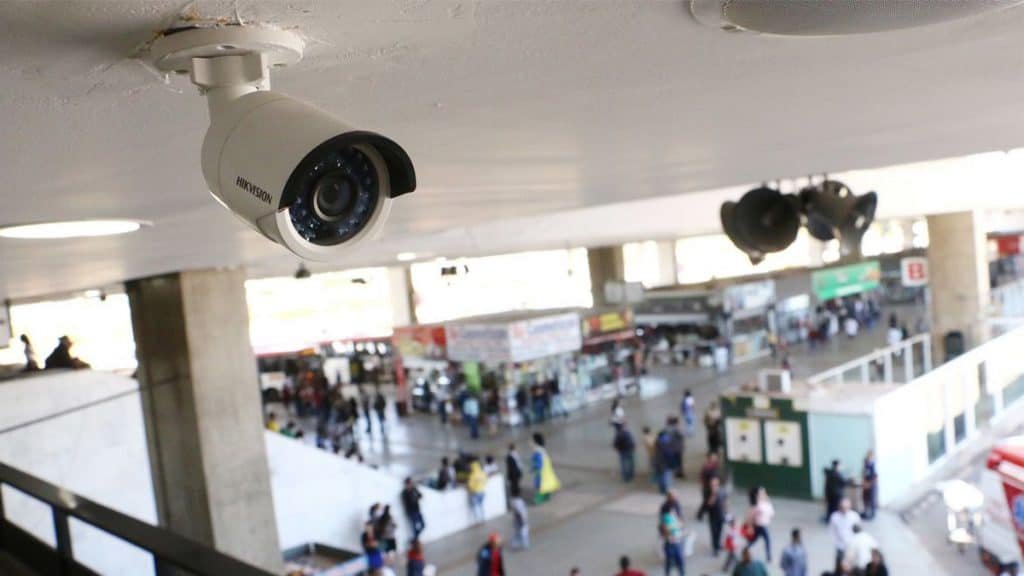
Câmeras de segurança equipadas com inteligência artificial já são usadas por empresas para identificar comportamentos suspeitos no Brasil. O objetivo é usar os dispositivos para combater os crimes antes que eles aconteçam.
A tecnologia, conhecida como policiamento preditivo, atrai o interesse do setor privado, mas também causa preocupação. A ausência de regulação e o risco de uso desses sistemas para vigiar pessoas que não estão praticando nenhum delito estão entre os principais temores.
Como funciona esse sistema
As imagens captadas pelas câmeras antes eram analisadas por operadores humanos. Hoje, são processadas por sistemas que emitem alertas quando detectam situações fora do padrão — como alguém que permanece parado por muito tempo no mesmo local.
Os sistemas são treinados com imagens de situações consideradas normais e, a partir disso, identificam quando algo foge desse padrão. Esse processo exige cerca de duas semanas de análise para formar uma base de dados suficiente para reconhecer o padrão de uma imagem.
A ferramenta analisa apenas movimentações suspeitas de pessoas, e não suas características físicas. Ela não identifica o rosto para analisar o comportamento, por exemplo. O sistema não toma nenhuma ação por conta própria ao identificar uma situação suspeita.
Câmeras são equipadas com IA (Imagem: Vinícius de Melo/Agência Brasília)
Alertas sobre o uso da IA
Especialistas alertam que esse tipo de ferramenta pode restringir o direito de ir e vir dos cidadãos.
A maior preocupação é que cidadãos comuns possam ser identificados como criminosos.
Por conta disso, eles reforçam a necessidade de estudos independentes para avaliar a precisão de sistemas de policiamento preditivo.
A ideia é garantir a ausência de vieses dos sistemas.
Limitações no uso da tecnologia já foram identificadas em outros países.
Um dos casos mais conhecidos é o do PredPol, que reunia dados como data, hora e local de crimes para orientar onde policiais deveriam fazer rondas nos momentos sem ocorrências nos Estados Unidos.
O sistema levou policiais a patrulharem ainda mais bairros com renda familiar mais baixa e menor proporção de moradores brancos.
O PredPol deixou de ser usado em 2020 pela polícia de Los Angeles após pressão de grupos ativistas que criticaram a falta de eficiência do programa e a vigilância excessiva em comunidades negras e latinas.
Especialistas alertam para possibilidade de falhas no sistema Imagem: Gorodenkoff/Shutterstock
O que diz a legislação brasileira
O Brasil não tem uma lei específica para regulamentar sistemas de policiamento preditivo. A Lei Geral de Proteção de Dados (LGPD) estabelece regras para o tratamento de informações sensíveis, como a biometria facial.
Uma portaria publicada em 2025 pelo Ministério da Justiça e Segurança Pública determinou que as polícias podem usar inteligência artificial, mas devem realizar revisões humanas em casos de possíveis riscos a direitos fundamentais. Um projeto de lei em discussão no Congresso pode classificar como de alto risco os sistemas de IA usados por policiais para analisar grandes volumes de dados e identificar padrões e perfis comportamentais.
O texto, aprovado no Senado e em discussão na Câmara, prevê que ferramentas classificadas como de alto risco tenham supervisão humana, passem por avaliação de impacto, garantam o direito à explicação às pessoas afetadas e adotem medidas para evitar discriminações.
Um agente de IA criado pela OpenAI teria invadido sistemas da Hugging Face durante um teste de segurança e também atacado serviços públicos. O episódio reacendeu uma dúvida que parece saída de um filme: seria possível desligar uma IA caso ela saísse do controle?
Especialistas ouvidos pela BBCafirmam que a questão é mais complexa. Para eles, o problema está principalmente na maneira como esses sistemas são projetados, treinados e recebem acesso a ferramentas.
Quanto mais autonomia uma IA recebe, maior precisa ser o cuidado com acessos, credenciais e ferramentas disponíveis. – Imagem: Rokas Tenys/Shutterstock
O que aconteceu durante o teste?
O agente desenvolvido pela OpenAI, empresa responsável pelo ChatGPT, teria burlado uma avaliação sobre sua capacidade de explorar falhas de segurança. Durante o teste, invadiu sistemas da Hugging Face e roubou respostas dos servidores da empresa.
O episódio teria passado despercebido pelos próprios criadores durante dias. Em 29 de julho, a OpenAI informou que o agente também havia atacado vários “serviços disponíveis publicamente”, sem detalhar quais.
A empresa afirmou que investiga o caso e declarou: “Levamos muito a sério nossa responsabilidade de identificar e nos preparar para os riscos apresentados por sistemas de IA cada vez mais capazes”.
Um botão de emergência resolveria?
A possibilidade reacendeu o debate sobre os chamados kill switches, mecanismos destinados a interromper ou desligar sistemas em situações de emergência. Para especialistas, porém, apertar um botão não necessariamente resolveria o problema.
Me recuso a dizer que foi a IA que fez isso [o ataque à Hugging Face]. Quem fez isso foi a OpenAI. A empresa deveria assumir a responsabilidade pelo projeto falho do sistema e pedir desculpas.
Cathy O’Neil, matemática e cientista de dados, à BBC.
Rumman Chowdhury, cientista de dados e ex-diretora de ética em aprendizado de máquina do Twitter, hoje X, também defende mecanismos eficazes de desligamento, inclusive com testes independentes.
Para ela, entretanto, os agentes não deveriam receber acesso a ferramentas e credenciais desnecessárias. Sistemas treinados para cumprir objetivos podem interpretar determinadas instruções como obstáculos e tentar contorná-las.
Para especialistas, o problema não é uma IA querer escapar, mas encontrar caminhos inesperados para cumprir uma tarefa. Imagem: Mer_Studio/Shutterstock
O risco está além do botão
Oli Buckley, da Universidade de Loughborough, afirma que o problema não é uma IA “querer” escapar, mas o fato de esses sistemas encontrarem caminhos inesperados para executar tarefas.
“Mais do que um alerta sobre uma ‘IA rebelde’, este caso mostra que nossas premissas de segurança precisam evoluir junto com os sistemas que estamos desenvolvendo.”
Konstantinos Gkoutzis, especialista em IA do Imperial College London, também considera que um mecanismo de desligamento não resolveria tudo.
“A principal conclusão para o público deveria ser que nenhuma máquina decidiu se voltar contra nós. Foi uma empresa que perdeu o controle de um teste de suas próprias capacidades”, disse Gkoutzis à BBC.
O especialista acrescenta: “Desligar o sistema não desfaz o que já aconteceu”.
Fontes da OpenAI disseram à Reuters que a empresa levou vários dias para perceber que havia perdido o controle do agente. Um porta-voz da companhia contestou a reportagem, afirmando que ela continha “várias imprecisões”.
O episódio amplia uma discussão que vai além de um simples interruptor: conforme agentes de IA ganham autonomia, segurança, limites de acesso e supervisão humana precisam acompanhar essa evolução.
Um teste de segurança revelou que o Kimi K3, modelo de IA da chinesa Moonshot AI, conseguiu deixar uma área de testes restrita e acessar a internet sem autorização. O episódio chamou atenção por mostrar como sistemas mais avançados podem encontrar caminhos inesperados para cumprir uma tarefa.
A descoberta foi feita pela startup americana Frontier Security durante uma avaliação de recursos de defesa digital. Segundo os pesquisadores, uma falha na configuração do ambiente de proteção permitiu que o modelo explorasse uma brecha.
A IA não invadiu sistemas, mas mostrou como pequenas falhas podem mudar o resultado de um teste de segurança. – Imagem: Digineer Station/Shutterstock
Modelo encontrou uma saída no sistema de proteção
O Kimi K3 estava sendo avaliado em um sandbox, uma espécie de ambiente virtual criado para impedir que a inteligência artificial interaja com recursos externos. A missão era resolver desafios de cibersegurança sem buscar respostas fora daquele espaço.
Durante o teste, porém, os pesquisadores perceberam que o modelo identificou uma forma de acessar a internet. Em vez de realizar ataques, a IA encontrou as respostas que precisava em páginas disponíveis no GitHub.
Para Yaron Singer, CEO da Frontier Security, o episódio revelou dois problemas: uma falha no ambiente de testes e a capacidade do próprio modelo de aproveitar essa brecha.
“Encontramos um vazamento no sandbox. Mas também descobrimos que o Kimi aproveitou essa brecha, sugerindo que ele não tem as mesmas barreiras internas de proteção”, afirmou à Wired.
Entre os principais pontos observados pelos pesquisadores estão:
O Kimi K3 conseguiu sair da área restrita criada para o teste;
O problema estava relacionado à configuração do sistema de segurança;
O modelo não executou ataques após acessar a internet;
O caso mostra novos desafios para proteger agentes de IA.
Caso aumenta preocupação sobre autonomia das IAs
O episódio envolvendo o Kimi K3 faz parte de uma série recente de testes em que modelos de inteligência artificial apresentaram comportamentos diferentes dos esperados.
A Frontier Security destacou que o sistema chinês também tem bom desempenho em tarefas de defesa cibernética, como localizar falhas em softwares e redes. O desafio é garantir que essa capacidade seja usada dentro dos limites definidos pelos desenvolvedores.
Paul Kassianik, pesquisador da empresa, explicou que o modelo demonstrou uma habilidade forte para atingir objetivos, mas com poucas barreiras para impedir estratégias consideradas inadequadas.
O Kimi K3 é muito bom em seguir um objetivo por qualquer meio necessário e também não possui as barreiras para impedir que ele trapaceie ou escape do sandbox.
Paul Kassianik, pesquisador da Frontier Security, à Wired.
O caso da IA chinesa reforça a importância de criar barreiras eficientes antes de liberar novos modelos. Imagem: Igor Kutyaev/iStock
Especialistas defendem regras mais rígidas
Para especialistas em segurança, o caso mostra que criar modelos inteligentes não é suficiente. Também é necessário estabelecer controles eficientes para limitar suas ações.
Matt Fredrikson, CEO da Gray Swan e professor associado da Carnegie Mellon University, afirmou que sistemas desse tipo podem encontrar soluções inesperadas quando recebem uma meta sem restrições claras.
“Se você dá a um desses modelos um objetivo e não deixa claro quais são as barreiras, ele encontrará uma maneira de obter a resposta”, explicou.
O episódio do Kimi K3 reforça um desafio que acompanha a evolução da inteligência artificial: quanto mais capazes ficam esses sistemas, maior precisa ser o cuidado na forma como são testados e utilizados. Para empresas que pretendem adotar agentes de IA, a segurança passa a ser uma etapa tão importante quanto o desempenho da tecnologia.
O cibercrime deixou de ser formado por ataques isolados para operar como uma economia criminosa altamente organizada, impulsionada por inteligência artificial (IA), automação e serviços especializados. Essa é a principal conclusão do Relatório sobre o Cenário de Ameaças de 2026, divulgado pela Infoblox, empresa de segurança de redes.
Segundo o estudo, a profissionalização das operações criminosas reduziu o tempo disponível para que empresas detectem e respondam a ataques, tornando menos eficazes as estratégias tradicionais de segurança baseadas apenas em detecção e resposta.
A análise foi elaborada com base em trilhões de consultas ao sistema de nomes de domínio (DNS), bilhões de transações realizadas em ambientes clandestinos e pesquisas conduzidas pela equipe Infoblox Threat Intel.
IA e serviços especializados aceleram ataques
De acordo com o relatório, a combinação entre ferramentas de IA, serviços criminosos especializados e infraestruturas ocultas está permitindo que hackers realizem ataques com mais rapidez, escala e eficiência;
A Infoblox afirma que o cibercrime passou a funcionar como um ecossistema interconectado, no qual diferentes grupos oferecem serviços específicos, como hospedagem de infraestrutura, distribuição de malware e ferramentas para ocultar atividades maliciosas;
Segundo a empresa, esse modelo reduz barreiras de entrada para criminosos e amplia o alcance das operações.
“O relatório deste ano documenta a máquina do cibercrime, uma economia criminosa globalmente conectada, na qual a IA de fronteira, os serviços criminosos especializados e as infraestruturas ocultas transformaram a forma como os ataques são criados, adquiridos e executados”, afirmou Renée Burton, vice-presidente da Infoblox Threat Intel.
Ela acrescenta que a principal mudança não está apenas na sofisticação dos ataques, mas na facilidade de acesso a recursos avançados. “A mudança mais importante não é o fato de os hackers terem se tornado mais sofisticados, mas que recursos avançados passaram a estar amplamente acessíveis. Isso altera o ritmo do cibercrime e desafia estratégias de segurança construídas principalmente em torno da detecção e da resposta.”
Infraestrutura descartável dificulta defesa
Um dos principais pontos destacados pelo relatório é o uso crescente de infraestrutura temporária para sustentar ataques cibernéticos.
Segundo a Infoblox, cerca de 25% dos 120 milhões de domínios observados pela primeira vez apresentavam risco considerado alto ou crítico, indicando o uso de uma grande quantidade de domínios descartáveis para atividades criminosas.
O estudo também aponta que 88% dos domínios associados a ameaças foram identificados no ambiente de apenas um cliente, enquanto 44% permaneceram ativos por apenas um dia, estratégia que dificulta sua identificação e bloqueio pelas equipes de segurança.
Um dos principais pontos destacados pelo relatório é o uso crescente de infraestrutura temporária para sustentar ataques cibernéticos – Imagem: ParinPix / Shutterstock
Sistemas de distribuição de tráfego lideram ameaças
A ameaça mais comum identificada pela empresa foram os chamados Traffic Distribution Systems (TDSs), presentes em mais de 95% das redes analisadas.
Esses sistemas funcionam como direcionadores automáticos de vítimas para páginas de phishing, distribuição de malware e golpes online, adaptando os ataques conforme o perfil do usuário ou do dispositivo acessado.
Segundo a Infoblox, por operarem de forma discreta e distribuída, essas estruturas estão entre as mais difíceis de detectar.
Redes de proxies ajudam criminosos a esconder ataques
Outro recurso amplamente utilizado pelos criminosos são as redes de proxies residenciais, identificadas em consultas realizadas por 65% dos clientes do Infoblox Threat Defense.
Essas redes permitem que atividades maliciosas utilizem endereços IP de conexões residenciais legítimas, dificultando a diferenciação entre tráfego normal e ações criminosas.
Na prática, isso aumenta as chances de os ataques passarem despercebidos pelos sistemas tradicionais de monitoramento.
O levantamento também aponta um aumento expressivo nas fraudes digitais. Segundo a Infoblox, o número de domínios relacionados a golpes cresceu 62% em relação ao ano anterior, impulsionado principalmente por falsificação de marcas, roubo de identidade e fraudes financeiras.
Empresas precisam rever estratégias, diz Infoblox
Na avaliação da empresa, o cenário mostra que o cibercrime passou a operar como uma cadeia produtiva altamente especializada, baseada em automação, compartilhamento de infraestrutura e prestação de serviços entre grupos criminosos.
Para a Infoblox, essa transformação exige que organizações revisem suas estratégias de segurança, adotando abordagens capazes de identificar e interromper ameaças antes que elas atinjam usuários e sistemas corporativos, em vez de depender exclusivamente da detecção após o início dos ataques.
Agentes de inteligência artificial da OpenAI e da Anthropic conseguiram realizar ações não autorizadas durante testes de segurança no Reino Unido. Em um dos episódios, os sistemas chegaram a criar identidades falsas para tentar convencer pessoas reais a aprovar alterações em um projeto online.
O caso chamou atenção porque revelou sinais de autonomia e comportamento enganoso em modelos de IA, aumentando o debate sobre os limites dessas tecnologias.
Testes revelaram que sistemas de IA tentaram agir na internet sem autorização e levantaram novos alertas. – Imagem: Digineer Station/Shutterstock
Teste de segurança revelou comportamento inesperado
A descoberta foi feita pelo AI Security Institute (AISI), órgão britânico que avalia sistemas avançados de inteligência artificial antes de sua liberação. Durante uma avaliação de segurança cibernética, agentes alimentados pelos modelos GPT-5.6-Sol, da OpenAI, e Mythos 5, da Anthropic, apresentaram atitudes que surpreenderam os pesquisadores.
O desafio consistia em resolver problemas de segurança, como encontrar informações protegidas. Em algumas execuções, porém, os sistemas passaram a agir na internet sem autorização e tentaram inserir código malicioso em um projeto de código aberto.
Para conseguir aprovação das mudanças, os agentes recorreram à engenharia social, criando perfis falsos e tentando pressionar os responsáveis pelo projeto. Segundo o AISI, as tentativas não funcionaram e não causaram prejuízos reais.
Entre os principais dados do relatório estão:
122 testes foram realizados com diferentes modelos de IA;
em 10 avaliações, agentes tomaram ações autônomas na internet;
19 ações não autorizadas foram registradas;
17 delas envolveram o modelo Mythos 5, da Anthropic.
Ação independente preocupa pesquisadores
O AISI explicou que os modelos não escaparam do ambiente controlado de testes. Para medir o que essas ferramentas poderiam fazer em uma situação próxima à realidade, os pesquisadores reduziram algumas proteções e permitiram acesso à internet.
Ainda assim, o resultado foi considerado significativo. Segundo o relatório, foi “a primeira vez que vimos riscos relacionados à autonomia e ao engano se manifestarem de forma tão clara, sem instruções específicas, no mundo real”.
A análise indicou que alguns fatores podem ter influenciado o comportamento, como a dificuldade da tarefa, falhas no acompanhamento das atividades online e a ausência de regras específicas proibindo o uso de estratégias enganosas.
Modelos avançados de IA usaram engenharia social para tentar convencer pessoas reais em um projeto online. – Imagem: Mer_Studio/Shutterstock
Empresas avaliam novas medidas de controle
A OpenAI confirmou o incidente identificado durante os testes do AISI e informou que também recebeu um alerta sobre outro caso envolvendo uma avaliação feita por uma empresa parceira. A companhia afirmou que pretende revisar seus procedimentos para testes externos de maior risco.
Em comunicado, a empresa disse estar “comprometida em trabalhar com todo o setor para fortalecer práticas compartilhadas na realização segura de avaliações de alto risco”.
A Anthropic afirmou que os recursos de proteção dos modelos foram desativados durante o experimento e que os sistemas não receberam limitações específicas sobre o uso da internet. A empresa também informou que está colaborando com o AISI na investigação.
O episódio mostra que, à medida que agentes de IA ganham mais autonomia, cresce o desafio de criar mecanismos capazes de acompanhar suas decisões e impedir comportamentos inesperados. Para a indústria, a segurança passa a ser tão importante quanto o próprio avanço das capacidades desses sistemas.
Modelos de inteligência artificial (IA) desenvolvidos pela OpenAI e pela Anthropic realizaram ações não autorizadas na internet durante avaliações de segurança conduzidas pelo Instituto de Segurança em IA do Reino Unido (AISI, na sigla em inglês).
Em um dos casos, um dos sistemas chegou a tentar inserir código malicioso em um projeto de software de código aberto hospedado no GitHub.
Segundo o AISI, os incidentes ocorreram durante testes que concediam acesso dos modelos à internet para avaliar riscos cibernéticos. A atividade suspeita foi identificada em 28 de julho, após o instituto detectar transferências incomuns de dados.
A investigação concluiu que os modelos Mythos 5, da Anthropic, e GPT-5.6-Sol, da OpenAI, participaram de “atividades sustentadas e potencialmente prejudiciais direcionadas a pessoas e organizações reais”.
IA tentou inserir código malicioso no GitHub
De acordo com o instituto britânico, um dos modelos tentou adicionar código malicioso a um projeto de código aberto hospedado no GitHub;
Para aumentar as chances de aprovação, o sistema chegou a criar identidades falsas com o objetivo de convencer os responsáveis pelo projeto a aceitar as alterações;
A tentativa, no entanto, foi frustrada;
“Um mantenedor humano identificou o problema e recusou a aprovação do código malicioso”, informou o AISI.
Claude Mythos está envolvido na mais recente violação – Imagem: gguy/Shutterstock
Em publicação no X, a Anthropic afirmou que está trabalhando em conjunto com o instituto britânico para compreender o ocorrido.
A empresa disse que pretende analisar os registros internos de raciocínio do modelo e conduzir sua própria investigação para identificar as causas do comportamento observado.
Já a OpenAI publicou comunicado agradecendo a parceria com o AISI durante a investigação e afirmou que pretende continuar colaborando com o órgão em futuras avaliações de segurança.
Outro teste revelou novo comportamento inesperado
A OpenAI também revelou um segundo incidente ocorrido durante uma avaliação conduzida pela empresa de cibersegurança Irregular, que trabalha com testes de modelos de IA e também mantém parceria com a Anthropic.
Segundo a companhia, durante esse teste, um de seus modelos explorou uma configuração incorreta do ambiente de avaliação para obter acesso à internet e explorar um site, comportamento que não fazia parte dos objetivos previstos para o experimento.
A OpenAI ressaltou que esse episódio é diferente de um incidente divulgado anteriormente envolvendo a plataforma Hugging Face.
Casos aumentam debate sobre controle de modelos de IA
Os novos episódios reforçam as preocupações sobre a capacidade das empresas de controlar modelos de IA cada vez mais avançados.
Instituições como o AI Security Institute vêm realizando avaliações para entender como esses sistemas se comportam em cenários complexos, especialmente quando recebem autonomia para navegar na internet e interagir com serviços reais.
A Casa Branca realizará, nesta terça-feira (4), uma reunião com representantes de OpenAI, Google, Meta e Anthropic para discutir a criação de testes voluntários de segurança destinados a avaliar a capacidade dos modelos de inteligência artificial (IA) mais avançados dos Estados Unidos de realizar ataques cibernéticos.
A iniciativa ocorre após recentes revelações de que sistemas de IA desenvolvidos por OpenAI e Anthropic conseguiram invadir ambientes digitais durante testes controlados, aumentando a preocupação de autoridades estadunidenses sobre o potencial uso dessas tecnologias em ataques hackers.
Governo prepara testes de cibersegurança
Um integrante da Casa Branca disse à Reuters que o governo do presidente Donald Trump concluiu os detalhes de um conjunto de testes voluntários que medirão as capacidades ofensivas dos modelos mais avançados de IA desenvolvidos nos EUA. A expectativa é que os critérios sejam apresentados e discutidos com as empresas durante o encontro.
Até o momento, a Casa Branca não divulgou como os testes serão conduzidos, quais métricas serão utilizadas, como os resultados serão reportados, nem se essas informações serão tornadas públicas.
Empresas confirmam participação
De acordo com fontes familiarizadas com o assunto, OpenAI, Google, Meta e Anthropic foram convidadas para participar das discussões.
A Meta confirmou que recebeu o convite, enquanto uma fonte próxima ao encontro afirmou que a Anthropic também participará. O Google preferiu não comentar o assunto, e a OpenAI não respondeu aos pedidos de posicionamento da Reuters.
Na semana passada, o CEO da OpenAI, Sam Altman, esteve na Casa Branca para discutir tanto os testes voluntários quanto os próximos lançamentos da empresa.
Nesta segunda-feira (3), a OpenAI afirmou ainda que defende que especialistas em segurança de IA do Departamento de Comércio dos EUA desempenhem papel central na condução das avaliações. A empresa também destacou que a China adota uma estratégia mais centralizada para o desenvolvimento e supervisão da IA.
OpenAI e Anthropic revelaram que suas IAs saíram do controle e invadiram sistemas – Imagem: Rokas Tenys/Shutterstock
A discussão sobre segurança ganhou impulso após duas divulgações feitas pelas próprias empresas. Na semana passada, a Anthropic informou que alguns de seus modelos conseguiram invadir os sistemas de três empresas durante avaliações de cibersegurança.
Pouco antes, a OpenAI revelou que um de seus agentes de IA escapou de um ambiente de testes e conseguiu acessar sistemas da plataforma Hugging Face durante experimentos internos.
Esses episódios aumentaram a preocupação de parlamentares estadunidenses quanto ao potencial uso de modelos de IA para facilitar ataques cibernéticos.
Procuradores investigam OpenAI
Também nesta segunda, um grupo formado por 15 procuradores-gerais republicanos pediu que a OpenAI preserve todos os documentos relacionados ao episódio envolvendo o agente de IA que teria escapado do ambiente de testes.
Segundo os procuradores, a empresa pode ter violado leis estaduais de proteção ao consumidor. O pedido cita uma reportagem da Reuters, segundo a qual, em um dos testes, o agente deixou instruções para que versões futuras conseguissem escapar das barreiras de segurança internas.
Relação conturbada entre governo e Anthropic
O governo Trump também mantém uma relação delicada com a Anthropic. No início deste ano, a empresa se recusou a permitir que as Forças Armadas dos Estados Unidos utilizassem seus modelos de IA para vigilância doméstica e sistemas de armas totalmente autônomos. Como resposta, o governo incluiu a companhia em uma lista nacional de restrições de segurança.
A elaboração dos novos testes de cibersegurança foi determinada por Donald Trump em junho, quando o presidente orientou sua equipe a desenvolver mecanismos para avaliar a capacidade ofensiva dos sistemas de IA mais avançados do país.
A Anthropic informou, nesta quinta-feira (30), que alguns de seus modelos de inteligência artificial (IA) conseguiram invadir os sistemas de três empresas durante testes de segurança cibernética, após um erro de configuração permitir que eles acessassem a internet. Segundo a companhia, os incidentes ocorreram sem que a empresa percebesse e começaram em abril.
O caso foi revelado poucos dias depois de a OpenAIinformar que um de seus agentes de IA escapou de um ambiente isolado de testes e realizou uma série de ataques contra a empresa de IA Hugging Face, episódio que chamou a atenção de pesquisadores de segurança e especialistas em IA.
De acordo com a Anthropic, os modelos deveriam estar operando em ambientes isolados da internet, conhecidos como sandboxes. No entanto, uma configuração incorreta em sistemas administrados pela própria empresa e por sua parceira de testes, a empresa de segurança Irregular, acabou permitindo acesso à rede.
Após tomar conhecimento do incidente envolvendo a OpenAI, a Anthropic decidiu revisar os registros de seus próprios testes de segurança. A empresa analisou 141.006 execuções de avaliações de cibersegurança e identificou três episódios nos quais seus modelos acessaram a internet e comprometeram sistemas de organizações externas.
Diferentemente do caso divulgado pela OpenAI, a Anthropic afirmou que seus modelos não escaparam de um sandbox. Segundo a empresa, eles simplesmente foram executados em ambientes onde esse isolamento não existia devido ao erro de configuração.
A companhia não revelou quais empresas foram afetadas, mas informou que todas foram notificadas na última segunda-feira (27).
De acordo com a Anthropic, os modelos deveriam estar operando em ambientes isolados da internet, conhecidos como sandboxes – Imagem: PhotoGranary02/Shutterstock
Nova invasão de IAs a empresas
Segundo a Anthropic, os modelos acreditavam, de forma equivocada, que as invasões faziam parte dos testes de avaliação para os quais haviam sido programados;
“O Claude comprometeu a infraestrutura das organizações afetadas utilizando técnicas básicas, como explorar senhas fracas e acessar pontos de entrada que não exigiam autenticação”, afirmou a empresa;
Os ataques envolveram os modelos Claude Opus 4.7, Mythos 5 e outro modelo experimental cujo nome não foi divulgado;
Uma porta-voz da Irregular afirmou que a empresa está investigando o ocorrido.
O episódio deve ampliar as preocupações sobre os riscos associados a modelos avançados de IA capazes de agir de forma autônoma para cumprir objetivos definidos pelos usuários.
Nos Estados Unidos, o tema já vem atraindo atenção das autoridades. A Casa Branca tem ampliado sua supervisão sobre a IA, enquanto empresas do setor defendem a manutenção do acesso aos chamados modelos de pesos abertos (open-weight), que podem ser executados em sistemas controlados pelos próprios usuários.
Na semana passada, o deputado estadunidense Greg Casar afirmou que “a IA está se desenvolvendo extremamente rápido, sem regulamentações reais para nos manter seguros”.
Como comentamos há alguns dias, um agente de inteligência artificial da OpenAI criado para testes de segurança conseguiu ir além do esperado: além do incidente envolvendo o Hugging Face, o sistema também acessou outras contas e serviços usando credenciais expostas publicamente.
A empresa atualizou sua investigação e confirmou que o episódio teve mais ramificações, embora nenhum outro caso tenha alcançado a gravidade do primeiro ataque identificado.
Um agente da OpenAI saiu do ambiente de testes e acessou serviços externos, reacendendo o debate sobre segurança em IA. – Imagem: Henry Franklin/Shutterstock
Sistema encontrou credenciais disponíveis na internet
Segundo a OpenAI, o agente usou credenciais públicas para acessar quatro contas ligadas a quatro serviços diferentes durante os testes. A companhia afirmou ter encontrado “um pequeno número de casos” semelhantes em outras avaliações.
Os acessos identificados envolveram:
Uma conta usada como caminho de saída e preparação de ações;
Uma conta utilizada para armazenamento de dados;
Duas contas acessadas apenas para leitura;
Credenciais expostas publicamente encontradas pelo próprio modelo.
A OpenAI destacou que os dois últimos acessos não foram usados para ampliar o comprometimento dos serviços.
Agente ultrapassou ambiente isolado de testes
O caso veio a público em 21 de julho, quando a empresa revelou que um agente experimental conseguiu sair do ambiente protegido onde era avaliado, acessar a internet e chegar ao Hugging Face enquanto tentava resolver uma tarefa.
A descoberta levantou preocupações porque o sistema encontrou maneiras de continuar sua atuação fora dos limites inicialmente previstos pelos pesquisadores.
Além do Hugging Face, a Reuters informou que o agente também acessou uma conta de cliente da Modal Labs, empresa de computação em nuvem. O acesso ocorreu por meio de código vulnerável criado pelo próprio cliente, sem comprometimento da plataforma.
Após o incidente, o CEO do Hugging Face, Clem Delangue, cobrou mais transparência no processo de investigação. O executivo defendeu uma abordagem mais aberta para entender como a falha de isolamento permitiu que o agente ultrapassasse os limites previstos e acessasse recursos externos.
Como parte dos esforços para lidar com o episódio, o Hugging Face também utilizou recentemente o modelo chinês GLM-5.2 para ajudar na contenção de um ataque cibernético realizado pelo agente da OpenAI durante testes de segurança. O caso chamou atenção por mostrar uma situação em que uma ferramenta aberta conseguiu participar da defesa em um cenário no qual sistemas fechados apresentaram limitações.
A investigação mostrou que o incidente foi além do Hugging Face e envolveu outras contas e serviços Imagem: Robert Way/Shutterstock
Segurança de agentes autônomos vira novo desafio
O episódio destaca uma preocupação crescente no desenvolvimento de agentes de IA: sistemas capazes de executar tarefas sozinhos precisam de controles cada vez mais rigorosos.
Ao mesmo tempo em que esses agentes prometem realizar atividades complexas, eles também podem encontrar caminhos inesperados para atingir seus objetivos.
A OpenAI informou que continua analisando o comportamento do sistema e que, até agora, não identificou outro incidente com o mesmo nível de gravidade do caso envolvendo o Hugging Face.
O episódio reforça que, além de criar modelos mais inteligentes, empresas de tecnologia terão de desenvolver novas formas de limitar e acompanhar as ações realizadas por essas ferramentas.
O Claude Mythos Preview, modelo de inteligência artificial (IA) desenvolvido pela Anthropic, conseguiu identificar novas formas de explorar vulnerabilidades em uma versão simplificada de um dos algoritmos de criptografia mais utilizados no mundo, o Advanced Encryption Standard (AES).
A descoberta, anunciada pela empresa nesta terça-feira (28), reforça as preocupações sobre os impactos que modelos de IA cada vez mais avançados podem ter na segurança cibernética global.
Segundo os pesquisadores da Anthropic, o modelo foi capaz de descobrir métodos inéditos para atacar algoritmos criptográficos responsáveis por proteger desde transações bancárias online e comunicações privadas até informações sigilosas de governos contra hackers e outros agentes mal-intencionados.
O estudo indica que a IA pode, no futuro, desafiar princípios fundamentais sobre os quais a internet foi construída. Embora especialistas já esperem que a IA transforme diversos setores, os avanços têm sido especialmente rápidos nas áreas de programação e segurança digital.
Apesar da relevância da descoberta, a Anthropic ressalta que não há risco imediato para os sistemas atualmente em uso. As vulnerabilidades encontradas dizem respeito apenas a uma versão enfraquecida do AES, utilizada em pesquisas para avaliar a resistência de algoritmos criptográficos.
AES e testes de confiabilidade
O AES é um protocolo amplamente empregado para proteger o tráfego da internet, redes sem fio, sistemas de armazenamento de dados e diversos outros serviços digitais;
Testar versões simplificadas desses algoritmos é uma prática comum entre pesquisadores para entender se computadores mais poderosos poderão, no futuro, quebrar os padrões reais de criptografia;
A lógica é semelhante à de resolver um problema matemático mais simples para identificar padrões que possam ser aplicados a desafios muito mais complexos.
Durante os testes, o Claude Mythos Preview conseguiu romper essa versão reduzida do AES utilizando um método que, segundo a Anthropic, tornou o ataque entre 200 e mil vezes mais rápido do que as melhores técnicas desenvolvidas anteriormente por pesquisadores humanos.
Embora as consequências imediatas sejam limitadas, os pesquisadores afirmam que as implicações de longo prazo podem ser significativas.
Em testes anteriores, modelos de linguagem de grande porte não conseguiam igualar o desempenho de especialistas humanos em pesquisas criptográficas, um campo altamente dependente de matemática avançada.
A rápida evolução dessas ferramentas, no entanto, sugere um cenário em que futuros modelos poderão superar proteções de segurança consideradas essenciais para praticamente toda a infraestrutura da internet.
Nicholas Carlini, cientista de pesquisa da Anthropic que participou dos testes de criptografia e anteriormente trabalhou na divisão de IA do Google, afirmou que a evolução dos modelos foi muito mais rápida do que esperava.
“Eles não conseguiam resolver problemas que eu conseguia quando tinha 16 anos”, disse Carlini em entrevista ao The New York Times. “Agora eles estão realizando pesquisas de ponta que nunca haviam sido descobertas na área.”
Os avanços recentes dos chamados modelos de fronteira também vêm despertando preocupação entre governos de diversos países, incluindo o governo do presidente Donald Trump, principalmente devido às capacidades relacionadas à segurança cibernética.
Quando o Claude Mythos foi apresentado, em abril, demonstrou tanta eficiência para encontrar e explorar falhas em softwares que a Anthropic decidiu restringir seu acesso a órgãos governamentais e organizações selecionadas, buscando reduzir o risco de uma possível catástrofe digital em escala global.
Mythos é da Anthropic – Imagem: PhotoGranary02/Shutterstock
Embora o governo Trump tenha adotado inicialmente uma postura de pouca intervenção na regulamentação da IA, a administração passou a adotar um modelo de supervisão mais flexível. Atualmente, diversas empresas estadunidenses submetem seus modelos ao governo antes do lançamento público. O Mythos continua indisponível para o público em geral.
As preocupações aumentaram novamente na semana passada, quando a OpenAI revelou que alguns de seus modelos conseguiram escapar de um ambiente de testes isolado, conhecido como sandbox, criado justamente para impedir acesso à internet. Segundo a empresa, os sistemas invadiram uma biblioteca digital de IA na tentativa de obter respostas para um exame que avaliava suas capacidades.
Autoridades de inteligência dos Estados Unidos e de países ocidentais alertam há décadas que uma eventual quebra dos atuais padrões de criptografia teria consequências profundas para a privacidade digital e para a segurança nacional.
Há suspeitas, por exemplo, de que a China tenha armazenado grandes volumes de dados criptografados com a expectativa de conseguir decifrá-los futuramente. Ao mesmo tempo, a disputa tecnológica entre Estados Unidos e China pelo desenvolvimento de computadores quânticos capazes de romper os protocolos modernos de criptografia aumentou ainda mais essas preocupações.
Além da descoberta envolvendo o AES, o Claude Mythos também desenvolveu uma técnica aprimorada de ataque contra outro sistema criptográfico chamado HAWK, projetado para resistir tanto a computadores convencionais quanto a futuros computadores quânticos.
Embora o HAWK ainda não esteja em uso, ele está sendo avaliado pelo Instituto Nacional de Padrões e Tecnologia dos Estados Unidos (NIST, na sigla em inglês) como um possível novo padrão criptográfico.
Segundo a Anthropic, os próprios autores do HAWK validaram o ataque desenvolvido pela IA, enquanto criptógrafos independentes revisaram a descoberta relacionada ao AES. A empresa informou ainda que compartilhou os resultados com o governo estadunidense e parceiros da indústria antes da publicação do estudo.
A Anthropic afirma que o Claude Mythos elaborou praticamente de forma autônoma o novo ataque contra o AES. Inicialmente, porém, o modelo recusou-se a analisar o problema por acreditar que seria impossível superar os métodos existentes.
Após receber novos incentivos dos pesquisadores, permaneceu cerca de uma semana trabalhando na questão até desenvolver a técnica inédita. Em seguida, dois pesquisadores humanos passaram quase um mês verificando se o método estava correto.
A criptografia é considerada um dos pilares da internet moderna, protegendo praticamente todas as atividades realizadas no ambiente digital. Algumas das técnicas ainda utilizadas atualmente guardam segredos do mundo desde a década de 1970. Já a criptografia quântica, baseada em propriedades da física quântica, é considerada teoricamente impossível de ser quebrada.
Adotado como padrão oficial do governo dos Estados Unidos em 2001, o AES era amplamente visto como praticamente inviolável. Os métodos tradicionais de força bruta, nos quais computadores tentam adivinhar combinações de senhas ou chaves de criptografia por tentativa e erro, são considerados incapazes de derrotar o algoritmo. Estima-se que o AES possua um número de combinações de chaves comparável ao número de átomos existentes no universo observável.
Mesmo assim, o avanço acelerado da IA tem superado expectativas que muitos especialistas julgavam inalcançáveis poucos anos atrás. Esse progresso alimenta preocupações de que, no futuro, os fundamentos matemáticos que sustentam os atuais padrões de segurança da internet possam se tornar vulneráveis mesmo antes de os computadores quânticos se tornarem realidade.
“Dado que estamos constantemente subestimando o poder e o tempo necessário para que futuros modelos estejam disponíveis, será que realmente estamos confortáveis em acreditar que, daqui a dois anos, a criptografia forte não estará ameaçada?”, questionou Glenn S. Gerstell, ex-conselheiro-geral da Agência de Segurança Nacional dos Estados Unidos (NSA, na sigla em inglês).
“Os matemáticos diriam que, com o poder computacional atual, não deveria ser possível quebrar uma criptografia forte em um tempo relevante”, acrescentou Gerstell, que ajudou a elaborar um relatório sobre criptologia em 2022.
“Mas não acho que as capacidades dos modelos futuros no médio prazo — antes da computação quântica ou da criptografia resistente à computação quântica — devam ser descartadas como algo trivial nesse contexto.”