A percepção do público em geral sobre a inteligência artificial virou centro de um debate no setor. Dario Amodei, presidente executivo da Anthropic — desenvolvedora do assistente Claude —, respondeu publicamente a críticas que o acusam de alimentar um clima de desconfiança em relação ao avanço da tecnologia nos Estados Unidos.
A reação do executivo ocorreu após declarações do investidor Gavin Baker. O investidor afirmou que os alertas de Amodei sobre os riscos potenciais da IA ajudaram a motivar a rejeição popular à expansão da infraestrutura do setor, como a construção de novos centros de dados. Para Baker, o líder da Anthropic deveria atuar como um defensor mais otimista da própria indústria.
Amodei rebateu a ideia de que sua comunicação seja focada apenas nos cenários negativos. O executivo apontou que busca manter o discurso equilibrado entre os perigos reais e as oportunidades da tecnologia.
Como exemplo, citou o ensaio Machines of Loving Grace, publicado por ele com o objetivo de apresentar uma visão positiva sobre como a inteligência artificial pode transformar diferentes áreas da sociedade.
Ainda assim, o CEO reconheceu que a percepção pública sobre a IA é predominantemente negativa. Para ele, no entanto, a origem desse cenário não está nos avisos dados pelos executivos das empresas do setor.
Crise de confiança e entrega de resultados
Na visão de Amodei, a rejeição decorre de uma crise de confiança acumulada ao longo de décadas entre a população, o governo e a indústria de tecnologia. Segundo o executivo, o público teme que as novidades corporativas tragam prejuízos ao usuário comum.
1/2 Thanks Gavin for an especially thoughtful exchange. I don’t usually spend much time on social media but I wanted to engage here because it really brings out the heart of an important conversation.
First, on regulation, I think that “either concentrate it in the hands of a… https://t.co/2W6vWJAE8Y
Amodei também destacou que a crítica mais justa que as empresas de IA enfrentam é a falta de entregas concretas proporcional ao tamanho das promessas feitas.
Falta de benefícios perceptíveis: O executivo admitiu que a indústria ainda não entregou todas as transformações positivas que prometeu para a sociedade.
Foco no produto: Para ele, a cobrança do público e do mercado deveria focar na entrega real dessas melhorias, e não nas estratégias de marketing das empresas.
O debate sobre a regulamentação do setor
O papel do governo na fiscalização da inteligência artificial é outro ponto central da discussão. A Anthropic apoiou projetos de lei nos Estados Unidos, como a proposta da Califórnia que exige regras de transparência para modelos de grande porte.
Em resposta a quem defende que regulamentar o setor serve apenas para concentrar o mercado nas mãos das maiores companhias, Amodei classificou essa visão como simplista. O executivo afirmou que as propostas de políticas públicas elaboradas pela Anthropic buscam impor exigências mais rigorosas às grandes empresas de ponta, sem criar barreiras que impeçam o crescimento de concorrentes menores.
A disputa pelos modelos de inteligência artificial de peso aberto mudou de mãos nos últimos seis meses. A família Qwen, desenvolvida pela chinesa Alibaba, ultrapassou a marca de 3 bilhões de downloads globais, deixando para trás os números da Meta e do Google no mesmo período.
O levantamento é da plataforma Hugging Face. Para efeito de comparação, os modelos abertos do Google registraram 418 milhões de downloads, enquanto os da Meta somaram 227 milhões.
Diferente de sistemas fechados como o ChatGPT, os modelos de peso aberto (open-weight) permitem que qualquer programador baixe a estrutura completa do sistema, modifique o código e crie suas próprias ferramentas. O volume de downloads é o principal indicador de qual tecnologia os desenvolvedores preferem usar.
Variedade de opções: A Alibaba abriu o código de mais de 460 modelos, que serviram de base para a criação de 300 mil projetos derivados.
Custo e facilidade: A combinação de modelos mais leves, baratos e fáceis de adaptar transformou a linha Qwen em uma escolha frequente para testes e projetos comerciais.
Presença em novos mercados: A empresa usou sua própria infraestrutura de nuvem para vender esses modelos para empresas no Sudeste Asiático e na África.
A competição entre China e Estados Unidos
O avanço da Alibaba e de startups chinesas como DeepSeek e Moonshot AI mostra que a distância técnica em relação às ferramentas norte-americanas está diminuindo.
Qwen é o modelo de IA aberta da chinesa Alibaba – Imagem: jackpress / Shutterstock
Mesmo com as restrições impostas pelos Estados Unidos para a venda de chips avançados para a China, o ritmo de download dos modelos chineses não caiu. Como resposta a esse avanço, empresas americanas como Meta e Nvidia voltaram a lançar novos modelos abertos nas últimas semanas para tentar reter os desenvolvedores.
Uma nova denúncia foi anexada ao processo movido por adolescentes do Tennessee contra a xAI, empresa de inteligência artificial fundada por Elon Musk. Uma mulher, identificada no processo como Jane Doe 4, alega que seu padrasto utilizou o gerador de imagens Grok para manipular uma foto tirada quando ela tinha 11 anos. Segundo a ação, a ferramenta foi usada para criar mais de 7 mil imagens de conteúdo sexual explícito.
Investigação policial e desfecho
De acordo com reportagem do The Washington Post, o caso foi descoberto durante uma operação de busca e apreensão realizada pela polícia:
Dois dias após as autoridades encontrarem o material, o suspeito foi encontrado morto em decorrência de suicídio.
Em declaração anexada ao processo, a vítima alertou sobre os riscos da facilidade de acesso a essas ferramentas no dia a dia.
Grok, IA de empresa de Elon Musk – Imagem: Samuel Boivin/Shutterstock
A acusação central do processo sustenta que a xAI falhou em implementar travas básicas de segurança para impedir a manipulação de fotos de pessoas reais, especialmente de menores de idade.
Os autores da ação buscam o status de processo coletivo. A denúncia se soma a uma série de críticas sobre a circulação massiva de imagens geradas por inteligência artificial sem o consentimento dos envolvidos.
A mudança atende a exigências do Código de Transparência da Lei de IA da União Europeia, que obriga empresas do setor a identificarem conteúdos criados por algoritmos.
Como funciona a marca d’água invisível?
O sistema não altera a qualidade do texto nem insere frases visíveis como “criado por IA”. A lógica funciona na escolha das palavras. Quando o Claude precisa decidir entre dois termos sinônimos e equivalentes — por exemplo, escolher entre usar a palavra “cinzento” ou “nublado” —, ele segue um padrão matemático específico.
Para quem lê, a resposta é idêntica a qualquer texto normal. No entanto, quem possui uma “chave” de verificação consegue identificar esse padrão invisível. A tecnologia adotada pela Anthropic utiliza a abordagem SynthID-Text, desenvolvida originalmente pela equipe do Google DeepMind em 2024. A empresa também informou que lançará uma ferramenta pública (API) para permitir essa detecção.
Anthropic é a criadora do Claude – Imagem: PhotoGranary02/Shutterstock
Essa solução difere dos detectores de IA tradicionais, que tentam adivinhar a autoria analisando vícios de linguagem ou estruturas de frases recorrentes. O novo método busca uma assinatura digital direta inserida na origem.
É possível remover a marca? E como fica o código?
A eficiência do rastreio depende do quanto o texto original for alterado:
Edições leves: Pequenas correções humanas não apagam a marca d’água completamente.
Reescrita total: Se todas as palavras forem substituídas por um humano, a marca desaparece. Nesses casos, o texto deixa de ser considerado estritamente gerado por IA.
Revisão de textos humanos: Caso o Claude seja usado apenas para corrigir um texto feito por uma pessoa, a presença da marca será mínima ou nula, pois a maior parte das palavras continua sendo do autor original.
No caso da programação, o impacto do rastreio é menor. Como o código de computador exige regras rígidas para funcionar, o modelo tem menos margem para escolher palavras alternativas. As marcas d’água em programação devem se limitar a trechos arbitrários, como os comentários explicativos inseridos no meio do código, sem afetar o funcionamento do programa.
Outras grandes desenvolvedoras do mercado de inteligência artificial também assinaram o mesmo compromisso e devem implementar sistemas semelhantes em breve.
🔍 Curadoria Studio Mestre Digital: Nossa equipe monitora as principais movimentações de mercado e tecnologia para manter você atualizado.
A aproximação entre empresas americanas e chinesas é algo cada vez mais raro em meio à escalada das tensões entre Washington e Pequim, com ramificações em diversas frentes, entre elas, a tecnologia. Mas há quem esteja indo na contramão dessa relação cada vez mais conflituosa. Esse é o caso da Apple. Segundo a agência Reuters, […]
O post Apple e Alibaba se unem em IA e “desafiam” tensão entre EUA e China apareceu primeiro em NeoFeed.
Insight Studio Mestre: Esta notícia reflete tendências que podem impactar diretamente o seu modelo de negócio digital.
A empresa chinesa Z.ai anunciou nesta sexta-feira (14) que seu modelo de inteligência artificial GLM-5.3 alcançou desempenho ligeiramente superior ao Mythos 5, da Anthropic, em um teste voltado à identificação de vulnerabilidades em softwares. O resultado coloca a tecnologia chinesa entre os sistemas de IA capazes de atuar em tarefas avançadas de segurança cibernética.
No CyberGym, avaliação que mede a capacidade de examinar códigos, localizar falhas e confirmar se elas são efetivamente exploráveis, o GLM-5.3 registrou 84,5%, contra 83,8% do Mythos 5. Os números, porém, foram divulgados pela própria Z.ai e ainda não passaram por verificação independente.
A vantagem chinesa desapareceu em uma etapa mais próxima da execução prática de ataques. No ExploitBench, o modelo da Z.ai marcou 54,4%, enquanto o sistema da Anthropic chegou a 78%, indicando que o Mythos 5 mantém uma distância relevante quando a tarefa exige transformar vulnerabilidades identificadas em explorações efetivas.
Z.ai prepara lançamento com acesso controlado
IA – Imagem: Rawpixel.com/Shutterstock
A Z.ai pretende disponibilizar o GLM-5.3 publicamente em aproximadamente duas semanas. Antes disso, a companhia afirma que concluirá avaliações de segurança e aprimorará os mecanismos destinados a impedir usos maliciosos. As funções consideradas mais sensíveis deverão ficar inicialmente restritas a usuários verificados por meio de um programa de acesso confiável.
A estratégia representa uma mudança relevante para um modelo que a empresa pretende distribuir de forma aberta. A preocupação está no fato de que sistemas capazes de encontrar vulnerabilidades também podem facilitar ataques, especialmente quando seus pesos podem ser baixados, modificados e associados a outras ferramentas.
A empresa diz ter criado diferentes barreiras para reduzir esse risco. Entre elas estão filtros para pedidos potencialmente perigosos, mecanismos de acompanhamento da atividade do modelo e treinamento específico para que o sistema recuse solicitações consideradas maliciosas.
De acordo com a Z.ai, essas proteções procuram separar atividades ofensivas de aplicações legítimas, como conserto de falhas, aprendizado sobre segurança digital e avaliações autorizadas de sistemas. O problema apontado por críticos é que parte desses controles pode perder eficácia depois que o modelo passa a circular livremente e pode ser alterado por terceiros.
A preocupação com a abertura dos modelos foi um dos motivos apresentados pela empresa para estabelecer um período de acesso limitado. O lançamento inicial será destinado a um grupo selecionado de parceiros, com expansão posterior baseada em um processo que a Z.ai descreve como gradual e responsável.
Gabriel Wagner, pesquisador de governança de inteligência artificial da Concordia AI, avaliou que a decisão tem relevância para o cenário chinês de segurança de modelos abertos. Para ele, o adiamento do lançamento por razões de segurança representa um sinal de amadurecimento das práticas de gerenciamento de riscos relacionadas à distribuição dos pesos de sistemas de IA.
A estratégia também estabelece um paralelo com o Project Glasswing, iniciativa da Anthropic que restringe o acesso ao Mythos 5 a organizações previamente avaliadas. No caso chinês, entretanto, a Z.ai tenta apresentar a abertura do modelo como parte central da proposta, e não como uma vulnerabilidade comercial ou de segurança.
Disputa vai além dos testes de cibersegurança
Linhas de um código-fonte – (Reprodução: Chris Ried/Unsplash)
A Z.ai afirma que sistemas avançados de defesa digital não deveriam ficar concentrados entre poucos fornecedores de modelos fechados. A empresa defende que desenvolvedores de projetos abertos e equipes menores de segurança também possam utilizar recursos desse tipo.
Como parte dessa proposta, a companhia anunciou o Open Source Shield, iniciativa destinada a avaliar determinados projetos de código aberto, liberar o uso do modelo para atividades defensivas e incorporar recursos de auditoria de código ao ZCode, seu produto voltado à programação.
O desempenho do GLM-5.3 também precisa ser analisado em tarefas que envolvem maior duração. Em uma avaliação separada, a Z.ai informou que o sistema realizou 105 tarefas de desenvolvimento de ataques em duas horas e 130 em seis horas. O Mythos 5, nas mesmas janelas, completou 181 e 247 tarefas.
A Anthropic adotou uma estratégia mais restritiva com o Mythos. A empresa liberou o sistema, baseado no Claude Fable 5 e com suas proteções de cibersegurança retiradas, somente para organizações que passaram por avaliação prévia.
O GLM-5.3 não foi concebido exclusivamente como uma ferramenta de segurança. A Z.ai o apresenta como um modelo geral de programação que recebeu treinamento adicional e aprendizado por reforço para ampliar sua atuação em cibersegurança. A companhia afirma que partiu da mesma base utilizada no GLM-5.2 e ampliou o treinamento com ambientes de tarefas mais extensos e variados.
O movimento ocorre após o crescimento da popularidade do GLM-5.2 entre desenvolvedores de diferentes países. O modelo anterior ganhou espaço por suas capacidades de programação e de operação como agente, com usuários e analistas apontando desempenho próximo ao de sistemas norte-americanos de ponta, mas com custo consideravelmente menor.
A disputa também envolve outras empresas chinesas. Em junho, a companhia de segurança cibernética 360 declarou que seu sistema Tulongfeng havia atingido capacidade equivalente à do Mythos ao combinar modelos de IA, informações de segurança e ferramentas automatizadas. A alegação, assim como os números apresentados pela Z.ai sobre o GLM-5.3, não foi confirmada de forma independente.
No mês passado, a Hugging Face informou ter recorrido ao GLM-5.2 para se defender de uma invasão atribuída a um agente de inteligência artificial da OpenAI. O episódio reforçou o interesse pelo uso de modelos chineses em operações defensivas e mostrou que a tecnologia já vinha sendo empregada em cenários concretos de segurança.
O Google anunciou, nesta sexta-feira (14), que permitirá aos usuários remover a marca d’água visível de conteúdos produzidos por seus modelos de inteligência artificial (IA). A opção estará disponível para imagens, vídeos e músicas, mas a mudança não afetará os mecanismos invisíveis usados pela empresa para identificar conteúdos gerados por IA.
De acordo com a empresa, a remoção da marca visível não interfere no SynthID, sistema de marca d’água invisível do Google, nem nos metadados relacionados ao padrão C2PA, utilizados para indicar a procedência de conteúdos digitais.
Josh Woodward, vice-presidente do Gemini, afirmou em publicação no X que a opção estará disponível para os modelos Nano Banana, Omni e Lyria. O recurso poderá ser configurado no Gemini e no editor de vídeos da Google, o Flow, enquanto o suporte para a Busca do Google será disponibilizado posteriormente.
A mudança representa nova abordagem do Google para a identificação de conteúdos produzidos por IA. Embora as marcas d’água visíveis ajudem a indicar que determinado material foi criado por IA, elas também podem tornar os conteúdos menos úteis em trabalhos profissionais e criativos.
Segundo Woodward, a empresa pretende equilibrar a liberdade de uso dos conteúdos com a necessidade de manter mecanismos de identificação.
“Estamos encontrando um equilíbrio entre controle criativo e segurança: embora as marcas d’água visíveis agora sejam opcionais, as marcas d’água invisíveis do SynthID e os metadados C2PA continuam sendo utilizados para transparência. Assim, ainda é possível usar o Gemini ou o Busca para verificar se uma imagem foi gerada por IA.”
A nova opção será disponibilizada gradualmente nos próximos dias. Quando estiver disponível, o usuário poderá acessar Configurações > Marca d’água de mídia para ativar ou desativar a identificação visual dos conteúdos gerados.
Nano Banana é o principal motor do sucesso recente do Gemini e que também conta com novo recurso – Imagem: Danilo Oliveira/Olhar Digital
Identificação invisível continua
Apesar de permitir a retirada da marca visível, a Google afirma que os conteúdos continuarão carregando mecanismos que permitem identificar sua origem.
O SynthID insere uma marca d’água invisível no conteúdo, enquanto os metadados associados ao padrão C2PA fornecem informações sobre a procedência do arquivo. Dessa forma, a ausência do aviso visual não significa que o conteúdo deixará de ser identificável como uma criação de IA.
O próprio Google afirma que usuários ainda poderão recorrer ao Gemini ou à Busca para verificar se uma imagem foi gerada por IA.
Além da mudança nas marcas d’água, a companhia anunciou a abertura do código de uma nova biblioteca chamada Credentio. A ferramenta permitirá que desenvolvedores incorporem mecanismos de validação local em seus próprios aplicativos.
A decisão do Google ocorre em momento de debate sobre a melhor maneira de identificar conteúdos produzidos por IA. Um exemplo é a decisão recente da Anthropic de incluir uma marca d’água em textos e arquivos gerados pelo Claude para atender a regulamentações da União Europeia (UE).
A OpenAI perdeu mais um nome importante do alto escalão. Denise Dresser deixou o cargo de CRO na quinta-feira, apenas dois dias depois de Brad Lightcap anunciar sua saída. As mudanças atingem a empresa enquanto ela se prepara para um possível IPO e sustenta uma avaliação de US$ 852 bilhões (cerca de R$ 4,37 trilhões).
Fidji Simo também está fora da companhia. As três saídas acontecem em meio à disputa com Google e Anthropic, à expansão de modelos de código aberto mais baratos e às expectativas dos investidores sobre o futuro da OpenAI, explica a CNBC.
Mesmo com mudanças no comando, a área corporativa da OpenAI dobrou e chegou a 2 milhões de clientes em um ano. – Imagem: Henry Franklin/Shutterstock
Dresser deixa o cargo
Dresser havia chegado à OpenAI em dezembro, depois de mais de uma década em posições de liderança na Salesforce. Ela recebeu a missão de expandir os negócios corporativos, considerados estratégicos na concorrência com a Anthropic.
Em abril, quatro meses após sua contratação, Dresser assumiu parte das atribuições de Lightcap. Ele deixou a função de diretor de operações para trabalhar em “projetos especiais” e anunciou nesta semana que encerraria uma passagem de oito anos pela empresa para “começar algo novo”.
A sucessora de Dresser será Dali Rajic, que ocupava o cargo de presidente e diretora de operações da Wiz, empresa de cibersegurança adquirida pelo Google por US$ 32 bilhões (cerca de R$ 164,16 bilhões).
Greg Brockman, presidente da OpenAI, afirmou que Dresser comandou a área de receita durante um “período de formação para o negócio”. Sobre Rajic, disse que ela deverá transformar o que a empresa aprendeu em uma operação mais consistente.
Área corporativa cresce
A mudança no comando não impediu a OpenAI de destacar os resultados obtidos no mercado empresarial. Segundo Brockman, a receita recorrente cresceu mais de 20% em julho, enquanto a expansão entre clientes corporativos chegou a 32%.
A divisão empresarial atingiu 2 milhões de clientes, o dobro do número registrado um ano antes.
Eu simplesmente nunca vi esse nível de convicção se espalhar tão rapidamente e de forma tão consistente pelas indústrias.
Denise Dresser, CRO da OpenAI, à CNBC.
Na mesma entrevista, ela afirmou que os negócios corporativos respondiam por 40% da receita e poderiam alcançar o mesmo peso dos consumidores até o fim de 2026.
Os números destacados pela OpenAI incluem:
2 milhões de clientes corporativos;
crescimento de 32% entre clientes empresariais em julho;
alta superior a 20% na receita recorrente em julho;
40% da receita vindos dos negócios corporativos, segundo Dresser;
avaliação de US$ 852 bilhões (cerca de R$ 4,37 trilhões).
A área corporativa já representa 40% da receita da OpenAI e pode alcançar o mesmo peso dos consumidores até o fim de 2026. – Imagem: Stock all/Shutterstock
IPO no horizonte
A OpenAI apresentou confidencialmente seu prospecto de IPO em junho, mas ainda não revelou uma data para a oferta.
A saída dos executivos chamou a atenção de investidores. Kevin McCormick, fundador da SignAudit.AI, classificou a debandada antes do IPO como um “grande sinal de alerta”. Dois investidores disseram à CNBC que ficaram surpresos com a decisão de Dresser.
Mudanças rápidas, porém, não são exatamente novidade na OpenAI.
Em 2023, Sam Altman foi afastado do cargo de CEO após o conselho afirmar que ele não era “consistentemente sincero em suas comunicações”. Dias depois, voltou à posição diante da reação de investidores e funcionários.
O episódio voltou ao centro das atenções durante o processo movido por Elon Musk contra a OpenAI, Altman e Brockman. Durante o julgamento, a gestão dos dois executivos foi questionada por advogados de Musk.
Com novas baixas no comando, Altman e Brockman terão de manter a confiança de investidores e funcionários enquanto a OpenAI tenta avançar no mercado corporativo e se preparar para uma possível abertura de capital.
Quem navega hoje por lojas de e-books, como a Amazon, encontra vários livros gerados por (ou escritos com) inteligência artificial (IA). São obras muitas vezes acompanhadas por capas genéricas e enredos padronizados. Hoje, criadores usam sistemas com IA que prometem um e-book pronto em menos de 30 minutos. E alimentam dezenas de pseudônimos com centenas de títulos lançados por ano.
Essa avalanche de lançamentos tem mexido no ecossistema editorial. Leitores reclamam de “conteúdos robóticos” de baixa qualidade. Autores humanos perdem visibilidade nas buscas e veem seu faturamento cair. Se a invenção do e-book facilitou a distribuição no passado, a IA agora derrubou o custo de produção. Mas o mercado está saturado. E agora? O grande desafio passou a ser encontrar clareza no meio de tanto ruído.
A IA acelerou a produção industrial de livros – e isso mexeu no mercado
O educador de tecnologias e artes do Sesc Piracicaba, Maurício Pinheiro, explica ao Olhar Digital que a IA mudou a escala do trabalho autoral independente. Hoje, uma única pessoa consegue pesquisar, estruturar, escrever, revisar e diagramar uma obra.
Isso permite ao autor operar quase como uma microeditora, testando capas, descrições e nichos diferentes numa velocidade inviável no modelo anterior.
Maurício Pinheiro, analista de software e educador, em entrevista ao Olhar Digital.
A IA mudou a escala do trabalho autoral independente no mundo dos livros, diz especialista – Imagem: krungchingpixs/Shutterstock
Essa facilidade transformou a lógica no mercado digital. Antes, produtores miravam emplacar best-sellers. Agora, o foco está no volume acumulado. Como o custo para gerar texto despencou, publicar dezenas de títulos em sequência tornou-se um negócio rentável. Mesmo que cada obra venda poucas cópias ou dependa do pagamento por páginas lidas em serviços de assinatura.
Os dados do setor reforçam o impacto dessa tática de produção industrial. Um estudo do National Bureau of Economic Research (NBER), por exemplo, aponta que o número de e-books lançados por mês na Amazon quase triplicou entre 2022 e o final de 2025.
Outra pesquisa, esta liderada pela Universidade Estadual de Nova York, revelou que a quantidade de livros com vendas registradas cresceu 19,2 vezes no período, enquanto a receita total do mercado aumentou apenas 8,9 vezes. Ou seja: há muito mais obras disputando a atenção dos leitores, o que derrubou o faturamento médio por título.
Para o educador, que também é analista de software, a queda nas barreiras de produção eliminou filtros tradicionais que garimpavam o que chegava às prateleiras. “Durante muito tempo, publicar era difícil, e essa dificuldade funcionava como um filtro anterior à chegada do livro ao público. Agora o filtro acontece depois”, pontua o especialista.
Agora, as próprias lojas virtuais enfrentam dificuldades para conter a enxurrada de conteúdo sintético. Na plataforma de autopublicação da Rakuten Kobo, por exemplo, 45% dos e-books submetidos num único ano foram recusados. E 85% dessas rejeições ocorreram porque os livros foram gerados por IA. Mesmo com bloqueios e análises, sistemas automatizados continuam a burlar a detecção. E a inserir títulos nas lojas diariamente.
O nó jurídico e a crise de valor: o que isso diz sobre o presente?
Além dos impactos no mercado, a produção em massa de e-books gerados por IA enfrenta uma barreira legal no Brasil. O advogado Marcelo Cárgano, especialista em Direito Digital no ABE Advogados, explica ao Olhar Digital que a legislação brasileira de direitos autorais é centrada na pessoa física e exige a criação humana para proteger uma obra.
“Um e-book inteiramente gerado por IA, sem intervenção criativa humana relevante, não possui uma pessoa física que possa ser reconhecida como autora daquela criação, e sem autor, não há proteção autoral”, diz Cárgano.
A produção em massa de e-books gerados por IA enfrenta uma barreira legal no Brasil – Imagem: N Universe/Shutterstock
Isso significa que esses livros podem ser livremente copiados por terceiros, além de trazerem outros riscos para quem os publica. Afinal, existe o perigo de a ferramenta reproduzir trechos protegidos de outros autores.
Além disso, há um debate sobre o direito do leitor em saber a origem do que está comprando. Mas o país ainda não exige que as plataformas sinalizem o uso da tecnologia nas capas.
“Poderíamos pensar que o consumidor tem direito à informação adequada e clara sobre os diferentes produtos e serviços em razão do CDC e que, portanto, os ditos autores e as plataformas que os publicam deveriam informar os consumidores sobre o fato de aquela obra ter sido gerada por IA”, pontua o advogado.
Essa fragilidade jurídica acompanha uma transformação no valor do próprio livro, para além da cifra monetária. Com algoritmos capazes de gerar histórias em grande quantidade, a capacidade de gerar um texto aceitável deixou de ser um diferencial.
O valor do mercado independente está migrando para o que a IA não consegue automatizar – Imagem: Roman Samborskyi/Shutterstock
A IA é extremamente competente em produzir aquilo que é plausível, familiar e suficientemente bom. Mas existe uma consequência curiosa: num oceano de coisas suficientemente boas, ser suficientemente bom deixa de ser uma qualidade rara.
Maurício Pinheiro, analista de software e educador, em entrevista ao Olhar Digital.
Nesse cenário de abundância, o valor do mercado independente migra para aquilo que não pode ser automatizado. Fatores como estilo próprio, repertório, experiência de vida e a segurança de que existe um autor real por trás das páginas passam a ter mais peso na escolha do leitor.
“Se o texto se torna praticamente infinito, aquilo que não pode ser produzido infinitamente passa a valer mais: confiança, reputação, perspectiva, repertório, experiência vivida, gosto e uma relação reconhecível entre uma obra e alguém disposto a responder por ela”, analisa o educador do Sesc Piracicaba.
No fim, a autopublicação virou uma luta contra o ofuscamento num catálogo sem fundo. “Não acho que a grande disputa será simplesmente entre autor humano e autor artificial. A disputa será entre sinal e ruído”, conclui Pinheiro.
Para o leitor, a tarefa de escolher o próximo livro para mergulhar torna-se mais complexa. Para o escritor humano, criar algo extraordinário passa a exigir um “molho secreto” que nenhuma máquina consiga replicar.
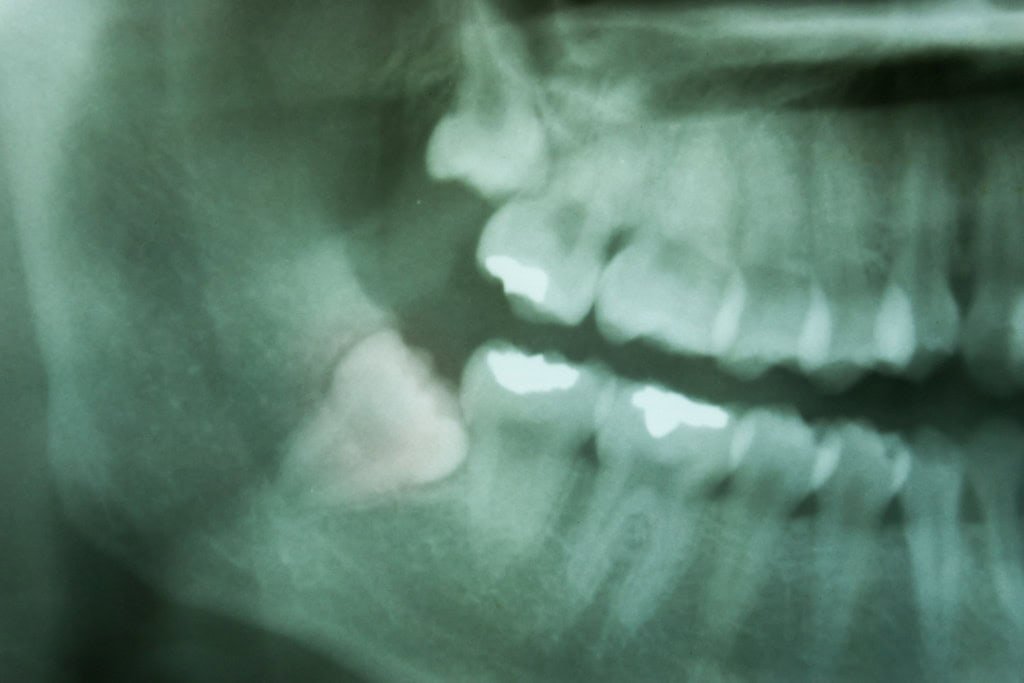
Pesquisadores da Universidade de São Paulo desenvolveram uma ferramenta de inteligência artificial capaz de reconhecer dentes e apontar sinais de cárie em radiografias odontológicas. Criada em Ribeirão Preto, a tecnologia foi desenvolvida para auxiliar dentistas na interpretação das imagens e pode contribuir para tornar avaliações clínicas mais rápidas e precisas.
O sistema nasceu da colaboração entre especialistas em computação da Faculdade de Filosofia, Ciências e Letras de Ribeirão Preto e profissionais da Faculdade de Odontologia da USP. A iniciativa reúne cerca de 30 pesquisadores no grupo InReDD, dedicado à criação de soluções digitais para a odontologia.
Baseada em redes neurais convolucionais, a ferramenta foi treinada com milhares de radiografias previamente avaliadas por especialistas. A proposta não é substituir o cirurgião-dentista, mas oferecer uma segunda avaliação capaz de apoiar decisões relacionadas ao diagnóstico e ao planejamento de tratamentos.
Uma segunda avaliação para o dentista
Radiografia – (Reprodução: umpo/Shutterstock)
O funcionamento da tecnologia começa pela preparação de uma grande quantidade de imagens odontológicas acompanhadas de avaliações feitas por especialistas. Esse material serve como referência para o treinamento do sistema, que procura estabelecer relações entre os padrões presentes nas radiografias e as alterações que precisa reconhecer.
A estrutura utilizada pertence à categoria das redes neurais convolucionais, desenvolvida especialmente para lidar com informações visuais. Conforme a explicação de Alessandra Alaniz Macedo, professora da área de Ciências da Computação da FFCLRP e uma das coordenadoras do projeto, esse tipo de arquitetura é adequado para tarefas que envolvem imagens, como as radiografias odontológicas.
Durante o treinamento, o modelo confronta suas próprias previsões com aquilo que foi previamente estabelecido pelos especialistas. Quando encontra diferenças, ajusta seus parâmetros para reduzir os erros. Esse ciclo permite que a ferramenta aprimore progressivamente sua capacidade de localizar alterações nas imagens.
A construção de um sistema desse tipo, porém, não se resume à programação do algoritmo. A seleção e preparação dos dados, o treinamento e a verificação do desempenho também fazem parte do processo científico conduzido pelos pesquisadores de computação.
Na rotina de um consultório, uma das possibilidades apontadas pelo grupo é utilizar a inteligência artificial como uma espécie de apoio adicional à análise feita pelo profissional. A ferramenta pode colaborar tanto na identificação de problemas quanto na elaboração do planejamento de um caso clínico.
O alcance pretendido pelo projeto vai além das radiografias. Segundo a equipe, soluções de inteligência artificial também podem ser empregadas em atividades administrativas de consultórios, como agendamento, atendimento de dúvidas simples e produção de materiais destinados à comunicação com pacientes.
Limites e responsabilidade profissional
(Imagem: Narongrit Doungmanee/iStock)
Apesar dos resultados considerados promissores, os pesquisadores ressaltam que a tecnologia ainda não deve ocupar o lugar do dentista. Um dos obstáculos está na dificuldade de explicar integralmente como determinados modelos chegam às conclusões que apresentam, característica que faz com que sejam frequentemente associados à ideia de uma “caixa-preta”.
Camila Tirapelli, professora da Faculdade de Odontologia de Ribeirão Preto e coordenadora do projeto ao lado de Alessandra Macedo, destaca que nenhum sistema de inteligência artificial é infalível. Por isso, a interpretação do resultado e a decisão sobre a conduta clínica permanecem sob responsabilidade do profissional.
A qualidade das informações utilizadas no treinamento também interfere diretamente no desempenho do sistema. De acordo com Tirapelli, dados inadequados podem levar a ferramenta a reproduzir erros presentes no material utilizado para ensiná-la. A integração entre profissionais da saúde e da computação, portanto, é apontada como elemento importante para a construção de modelos confiáveis.
Para os pacientes, a expectativa é de que ferramentas desse tipo possam reduzir o tempo necessário para determinadas avaliações e contribuir para diagnósticos mais precisos. Na pesquisa científica, a capacidade de processar grandes quantidades de radiografias também pode facilitar a identificação de padrões populacionais e apoiar investigações epidemiológicas em saúde bucal.
As soluções produzidas pelo InReDD foram pensadas para diferentes públicos, entre eles dentistas, radiologistas e pesquisadores. Embora os resultados obtidos até agora sejam considerados promissores, os sistemas ainda passam por aperfeiçoamentos antes de uma utilização mais ampla na prática clínica.
Pesquisa reúne computação e odontologia
O trabalho é resultado de uma cooperação entre duas unidades da USP em Ribeirão Preto e reúne pesquisadores, estudantes e docentes de diferentes níveis de formação. O grupo conta com participação de graduandos, mestrandos, doutorandos, um mestre, um pesquisador de pós-doutorado e professores das áreas envolvidas.
A iniciativa também recebe financiamento da Fundação de Amparo à Pesquisa do Estado de São Paulo. O projeto que deu origem à ferramenta busca integrar recursos de inteligência artificial e odontologia por meio da chamada fusão multimodal, ampliando as possibilidades de aplicação da computação na saúde bucal.
Para Alessandra Macedo, a combinação de diferentes funcionalidades em uma mesma solução representa um diferencial do trabalho desenvolvido pela equipe. O projeto já resultou em pesquisas acadêmicas, além de dissertações e teses, e também deu origem a um produto tecnológico cujo código foi registrado pela USP.
A expectativa dos pesquisadores é que novos estudos permitam aprimorar as ferramentas e ampliar suas aplicações. O horizonte apontado pelo grupo é uma odontologia em que a inteligência artificial esteja incorporada como recurso complementar, com a decisão clínica continuando sob responsabilidade do profissional.