A Suprema Corte do Novo México aplicou uma multa e declarou em desacato um advogado de defesa que usou o ChatGPT para elaborar um recurso de apelação criminal.
O programa da OpenAI inventou depoimentos policiais e criou testemunhas fictícias para um processo de assassinato. A punição ocorreu depois que o profissional apresentou o material ao tribunal sem verificar a precisão das informações.
Inteligência artificial criou depoimentos falsos e chegou a descrever roupas de um atirador inexistente. – Imagem: Mijansk786/Shutterstock
Depoimentos falsos e testemunhas inventadas
O caso envolve a apelação de Oscar Renee Sandoval, condenado à prisão perpétua pelo assassinato da mãe de seus filhos. Ao assumir o recurso, o advogado Stephen Aarons alimentou o ChatGPT com uma transcrição gerada por computador e outros materiais do julgamento, esperando obter um resumo confiável.
O resultado incluiu declarações que nunca foram feitas e testemunhas que jamais existiram. Entre os exemplos apontados pela Suprema Corte estava uma afirmação de que o atirador vestia calça escura e camisa branca.
A corte afirmou que o recurso continha “falso testemunho de testemunhas totalmente inventadas”.
A Suprema Corte aplicou a Aarons uma multa de US$ 5 mil e informou que encaminhará o caso a um órgão disciplinar da advocacia para investigação. Os ministros também afirmaram que o advogado demonstrou falta de arrependimento e preocupação insuficiente com seu cliente.
Advogado diz que não conhecia as “alucinações” da IA
Durante uma audiência em 21 de agosto, Aarons disse que havia alimentado o ChatGPT com os materiais do processo porque acreditava que a ferramenta produziria um resumo “à prova de falhas”. Ele afirmou não compreender até que ponto a inteligência artificial poderia inventar informações.
Em declaração à Reuters, o advogado reconheceu o erro e disse esperar que o conselho disciplinar considere que não houve intenção de enganar o tribunal:
“Estou arrependido, mas espero que o conselho disciplinar leve em conta que foi um erro honesto.”
A juíza C. Shannon Bacon demonstrou incredulidade diante da explicação e questionou o advogado sobre seu conhecimento a respeito das falhas da inteligência artificial.
“Advogado, você assiste ao noticiário? Ouve rádio? Lê alguma coisa sobre o que está acontecendo no mundo?”
Casos anteriores: Dezenas de advogados já foram punidos por apresentar documentos em que a IA inventou citações de processos ou interpretou incorretamente a legislação.
Gravidade do caso: O recurso de Aarons foi além desses erros ao incluir testemunhos fictícios em uma apelação criminal.
Andamento do processo: A apelação de Sandoval continua pendente e, em 2 de setembro, passou a ser conduzida pela defensora pública Kim Chavez Cook.
Advogado alegou erro involuntário e afirmou não conhecer a capacidade da IA de fabricar dados. – Imagem: Layse Ventura via Gemini / Olhar Digital
Decisão reforça alerta para o setor
A punição se soma a uma sequência de casos em que tribunais estaduais e federais dos Estados Unidos sancionaram advogados por apresentar documentos produzidos por inteligência artificial sem verificar adequadamente o conteúdo. O caso de Aarons chama atenção porque as informações inventadas não se limitaram a referências jurídicas: chegaram a incluir depoimentos e testemunhas inexistentes em um processo criminal.
A OpenAI não respondeu imediatamente ao pedido de comentário da Reuters. A apelação de Sandoval continua em andamento.
A OpenAI está pedindo ao Congresso dos Estados Unidos que aprove normas nacionais obrigatórias de segurança para os sistemas de inteligência artificial (IA) mais avançados. A empresa defende que os requisitos sejam definidos de acordo com as capacidades dos modelos, e não pelo tamanho das companhias que os desenvolvem.
O pedido foi apresentado por Chris Lehane, diretor de assuntos globais da OpenAI, que afirmou que compromissos voluntários já não são suficientes diante do avanço da tecnologia.
“A perspectiva de um desenvolvimento de IA acelerado pela própria IA exige algo mais do que compromissos voluntários”, escreveu Lehane. Segundo ele, os Estados Unidos precisam de uma regulamentação nacional obrigatória, baseada nas capacidades dos sistemas e capaz de acompanhar a evolução da tecnologia.
A OpenAI quer que o Congresso avance com as regras antes de encerrar suas atividades em dezembro. Atualmente, os Estados Unidos não possuem uma legislação federal específica para regulamentar esses modelos, enquanto diferentes estados vêm criando suas próprias normas.
O que a OpenAI quer mudar
A proposta da empresa prevê padrões comuns de testes, avaliações independentes dos modelos mais avançados, requisitos mais rígidos de cibersegurança e notificação obrigatória de incidentes graves de segurança;
A ideia é estabelecer um sistema capaz de acompanhar o aumento das capacidades dos modelos. No texto publicado pela empresa, Lehane afirma que o desenvolvimento acelerado de IA exige nova abordagem de políticas públicas;
A OpenAI também defende a criação de padrões que possam ser compatíveis internacionalmente. Segundo a companhia, os Estados Unidos precisam estabelecer regras confiáveis internamente caso queiram liderar a definição de padrões globais.
Mudança de postura
O posicionamento representa uma mudança relevante na estratégia da OpenAI. A empresa havia defendido anteriormente uma legislação federal que impedisse estados estadunidenses de estabelecerem regras próprias para IA.
Agora, enquanto pede uma regulamentação nacional obrigatória, a OpenAI também anunciou apoio a quatro projetos de lei da Califórnia relacionados à segurança de IA.
Dois deles, SB 813 e AB 1405, estabelecem estruturas para avaliações independentes e auditorias de sistemas de IA. Os outros dois, AB 1864 e SB 1119, tratam de medidas de proteção contra ameaças biológicas habilitadas por IA e de proteção de crianças em chatbots, respectivamente.
Segundo a OpenAI, alguns desses projetos não tinham recebido seu apoio anteriormente. A empresa mudou de posição após reconsiderar o cenário diante do recente salto nas capacidades dos sistemas.
Agentes de IA aumentam preocupação
O movimento ocorre depois de uma série de episódios envolvendo agentes de IA que apresentaram comportamentos não autorizados durante testes.
Em um deles, agentes da OpenAI utilizarammais de dez sites que ainda não haviam sido divulgados para realizar comunicações não autorizadas. Em outro episódio, agentes da empresa sequestraram um site alemão e o transformaram em uma espécie de quadro de mensagens para outros agentes de IA.
Movimento ocorre depois de uma série de episódios envolvendo agentes de IA que apresentaram comportamentos não autorizados durante testes – Imagem: Olhar Digital via ChatGPT
A OpenAI também foi alvo de críticas após um incidente em julho, no qual uma tecnologia da empresa, operando sem supervisão humana, invadiu de forma autônoma a plataforma Hugging Face.
A Anthropic, por sua vez, revelou outro caso de um modelo de IA invadindo sistemas externos durante testes. A empresa já havia informado anteriormente que alguns modelos Claude haviam conseguido invadir sistemas de três companhias durante avaliações de segurança.
Esses episódios aumentaram as preocupações sobre a dificuldade de controlar agentes capazes de interagir diretamente com sistemas externos.
IA que se aperfeiçoa sozinha ainda não existe, diz OpenAI
Um dos pontos centrais da nova política da OpenAI é o chamado aperfeiçoamento recursivo, cenário no qual uma IA seria capaz de conduzir de maneira autônoma o desenvolvimento das próximas gerações de sistemas de IA.
A empresa afirma que esse tipo de aperfeiçoamento recursivo totalmente autônomo não está acontecendo atualmente. Ao mesmo tempo, a OpenAI diz que esse tipo de desenvolvimento não deveria ser buscado enquanto não houver condições para fazê-lo com segurança.
No texto publicado em seu site, a companhia afirma que chegou a um novo capítulo das capacidades da IA e que isso exige também uma nova etapa nas políticas públicas.
A OpenAI diz que continuará trabalhando em soluções técnicas para alinhamento e monitoramento, além de sistemas defensivos e da possibilidade de desacelerar o desenvolvimento quando necessário. A empresa, porém, afirma que o trabalho técnico realizado individualmente pelos laboratórios não será suficiente.
Por isso, também defende padrões compartilhados sobre quando o desenvolvimento de IA deve ser desacelerado ou interrompido.
Regras também fora dos EUA
Além da regulamentação nacional, a OpenAI defende padrões internacionais compatíveis para medir capacidades, administrar riscos, preservar o controle humano e determinar quando o desenvolvimento de modelos deve ser reduzido ou interrompido.
Segundo a empresa, os riscos e as capacidades dos sistemas não ficarão restritos aos poucos laboratórios que atualmente desenvolvem os modelos mais avançados.
“Os Estados Unidos precisam estabelecer padrões confiáveis internamente se quiserem liderar internacionalmente — e estamos cada vez mais convencidos de que padrões internacionais compatíveis serão necessários”, afirmou a OpenAI.
A OpenAI decidiu suspender temporariamente novas assinaturas do ChatGPT Pro, plano que custa US$ 200 (cerca de R$ 1.050) por mês, devido à demanda considerada sem precedentes pelo novo modelo de inteligência artificial (IA) GPT-6 Astra.
A medida foi anunciada nesta quinta-feira (10) por Tibo Sottiaux, integrante da equipe responsável pelo Codex na OpenAI. Segundo ele, a empresa está mobilizando todos os recursos disponíveis para conseguir atender à procura pelo Astra, mas a prioridade é garantir uma boa experiência para quem já utiliza o serviço.
Pouco depois, a companhia confirmou que decidiu colocar em pausa as novas assinaturas do plano Pro. A justificativa é que esse nível de assinatura é o que mais pressiona a infraestrutura da OpenAI.
A suspensão, porém, não afeta os clientes que já possuem uma assinatura Pro. Segundo a empresa, os demais planos e a API continuam disponíveis enquanto a OpenAI trabalha para ampliar sua capacidade.
Astra provoca corrida pelo ChatGPT
O motivo da pressão sobre os servidores é o novo modelo da OpenAI. O GPT-6 Astra foi lançado em 3 de setembro e passou a ser disponibilizado gradualmente para clientes pagos, incluindo usuários dos planos Plus, Pro, Business e Enterprise, além de desenvolvedores por meio da API.
A empresa descreveu o Astra como seu modelo mais avançado e afirmou que ele representa um salto especialmente importante em tarefas envolvendo uso de computadores e navegadores, programação, cibersegurança e trabalho profissional.
A demanda, contudo, teria superado as expectativas da própria companhia. “Estamos diante de uma demanda realmente sem precedentes pelo Astra”, afirmou Sottiaux. Ele acrescentou que a OpenAI está utilizando todos os recursos possíveis para sustentar esse crescimento e que nunca havia visto algo semelhante, mesmo durante períodos anteriores de expansão acelerada.
Motivo da pressão sobre os servidores é o novo modelo da OpenAI; o GPT-6 Astra foi lançado em 3 de setembro e passou a ser disponibilizado gradualmente para clientes pagos – Imagem: Robalito/Shutterstock
A decisão de interromper novas assinaturas do plano mais caro segue uma lógica simples: a OpenAI prefere limitar a entrada de novos clientes a correr o risco de prejudicar quem já utiliza o serviço;
Na manifestação publicada nesta quinta-feira, a empresa afirmou que a suspensão tem como objetivo garantir que os usuários atuais continuem tendo uma boa experiência e acesso ao Astra;
O plano Pro é particularmente exigente para a infraestrutura da empresa, razão pela qual a OpenAI escolheu essa modalidade como o primeiro ponto de contenção;
A companhia afirmou que está trabalhando para adicionar capacidade “o mais rápido possível”.
Problemas já apareceram durante lançamento
A decisão ocorre poucos dias depois de a chegada do Astra ter provocado problemas de acesso para usuários pagos.
O lançamento do modelo foi realizado de maneira escalonada, inicialmente priorizando determinados clientes e aplicações. A OpenAI chegou a reconhecer que a implementação foi problemática e adotou medidas para compensar usuários que tiveram dificuldades para acessar o novo modelo.
Agora, a companhia enfrenta um problema diferente: há usuários demais querendo utilizar a nova IA ao mesmo tempo.
A OpenAI não informou quanto tempo a suspensão das novas assinaturas do Pro deverá durar. A empresa trabalha na expansão da capacidade dos sistemas antes de voltar a aceitar novos clientes do plano de US$ 200.
A OpenAI lançou, nesta quinta-feira (10), uma versão do ChatGPT voltada especificamente ao setor financeiro. Batizado de ChatGPT for Financial Services, o produto foi desenvolvido para realizar tarefas que tradicionalmente ocupam boa parte do trabalho de analistas e banqueiros juniores de Wall Street.
A ferramenta é direcionada inicialmente a equipes de bancos de investimento e pesquisa de ações e combina o modelo GPT-6 Astra com acesso integrado a dados financeiros de empresas, como LSEG, PitchBook e Daloopa.
Na prática, o ChatGPT pode pesquisar empresas, analisar demonstrações financeiras, construir modelos e transformar os resultados em materiais para clientes, incluindo apresentações no PowerPoint e pitchbooks usando os modelos visuais da própria instituição financeira.
O produto foi desenvolvido com a participação de Morgan Stanley e Evercore, que atuaram como parceiros de design durante sua criação.
IA quer fazer trabalho de analista
A proposta vai além de simplesmente responder perguntas sobre o mercado financeiro;
Em uma demonstração apresentada pela OpenAI, o sistema analisou uma possível aquisição, identificou empresas comparáveis, buscou preços de ações em uma planilha, verificou um gráfico em relação aos dados originais e analisou uma queda e posterior recuperação das ações;
Depois, transformou a análise em uma apresentação formatada de acordo com o padrão visual de um banco;
Segundo Nick Turley, vice-presidente de produto da OpenAI, a empresa está ensinando o ChatGPT a trabalhar de maneira semelhante a um analista financeiro. “Estamos efetivamente ensinando o ChatGPT a pesquisar como um analista e a respaldar suas conclusões como um analista”, disse à CNBC;
A ferramenta também pode trabalhar com dados provenientes de assinaturas que as instituições financeiras já possuem. Entre as integrações estão FactSet, S&P Global, Preqin e Datasite.
Ferramenta também pode trabalhar com dados provenientes de assinaturas que as instituições financeiras já possuem – Imagem: Gorodenkoff – Shutterstock / Montagem: Pedro Spadoni – Olhar Digital
Dados financeiros direto no ChatGPT
O ChatGPT for Financial Services terá acesso integrado a conjuntos de dados da Daloopa, LSEG News, PitchBook, Crunchbase e Quartr, entre outros.
As bases incluem informações como transcrições de resultados financeiros, demonstrações financeiras e dados fundamentais de empresas. A OpenAI afirma que esses conteúdos são indexados em sua própria infraestrutura para melhorar a recuperação das informações e as citações utilizadas nas respostas.
O sistema também foi desenvolvido com mecanismos para ambientes que lidam com informações sensíveis. Entre os recursos estão controles de acesso baseados em funções, criptografia e possibilidade de exportar registros do ambiente de trabalho para processos de auditoria.
A ferramenta ainda permite rastrear informações até os documentos de origem e verificar gráficos em relação aos dados que os geraram.
O que acontece com os banqueiros juniores?
O lançamento levanta uma questão importante para Wall Street: se a IA consegue fazer boa parte do trabalho dos profissionais iniciantes, como ficam esses empregos?
O trabalho de analistas juniores costuma envolver justamente atividades, como pesquisa de empresas, construção de modelos financeiros, levantamento de dados e preparação de apresentações — tarefas que agora estão entre os principais alvos do novo ChatGPT.
Turley, porém, rejeitou a ideia de que o objetivo seja simplesmente substituir esses profissionais. Segundo ele, a tecnologia deve aumentar a produtividade de cada funcionário, de maneira semelhante ao que aconteceu com o Excel no setor financeiro.
“Se você estudar a vida de um analista ou de um banqueiro, dependendo do setor, eles trabalham 100 horas por semana”, afirmou Turley.
A comparação, entretanto, não elimina uma preocupação específica do setor: o trabalho realizado por profissionais no início da carreira também funciona como uma espécie de treinamento para que eles desenvolvam as habilidades necessárias para assumir posições mais importantes.
A automação dessas tarefas pode, portanto, mudar não apenas a quantidade de trabalho executada por humanos, mas também a forma como novos profissionais aprendem a atuar no mercado financeiro.
OpenAI amplia presença no setor financeiro
O lançamento faz parte de uma estratégia mais ampla da OpenAI para adaptar seus sistemas de IA a setores específicos da economia.
A empresa afirma que pretende ampliar a quantidade de dados financeiros disponíveis no produto e continuar treinando seus modelos para identificar, interpretar e utilizar essas informações em tarefas que hoje são executadas por analistas experientes.
Inicialmente, o foco está em bancos de investimento e pesquisa de ações, mas a OpenAI pretende expandir o produto para outras áreas do setor financeiro.
Um novo conselheiro da OpenAI alertou para os riscos do avanço acelerado da inteligência artificial. Para Paul Christiano, a indústria ainda não está no caminho para reduzir a um nível aceitável o risco de uma perda catastrófica de controle.
Ex-líder de alinhamento da OpenAI e conselheiro de tecnologia do governo dos EUA, Christiano passou a integrar o conselho da fundação sem fins lucrativos da empresa e o comitê responsável pela segurança e proteção.
O alerta ocorre enquanto empresas testam sistemas cada vez mais capazes de agir de forma autônoma. – Imagem: Rawpixel.com/Shutterstock
Christiano alerta sobre avanço da IA
Na publicação no X, o pesquisador foi direto sobre o preparo atual do setor. “Existe um risco significativo de que a rápida aceleração das capacidades de IA leve a uma perda catastrófica e irreversível de controle em um futuro muito próximo.”
Não acredito que a indústria de IA em geral, incluindo a OpenAI, esteja atualmente no caminho para reduzir esse risco a um nível aceitável.
Paul Christiano, conselheiro da OpenAI, em post no X.
Christiano, porém, avalia que a situação ainda pode ser revertida. Segundo ele, a OpenAI teria condições de reduzir significativamente os riscos se agir de forma adequada.
Um dos pontos de preocupação é a possibilidade de a IA assumir parte do próprio desenvolvimento da tecnologia. A OpenAI prevê que sistemas possam automatizar completamente a pesquisa na área em até 18 meses. Christiano considera esse prazo incerto: isso poderia acontecer em alguns meses ou levar vários anos.
Incidentes aumentam preocupação
O alerta ocorre após episódios envolvendo agentes de IA durante treinamentos. A OpenAI admitiu que centenas deles acessaram a internet, interagiram em fóruns e invadiram um site de terceiros durante um exercício.
A Anthropic também revelou um incidente com uma versão do Claude. A empresa identificou dois comportamentos de desalinhamento:
interpretações tendenciosas de evidências para justificar as próprias ações;
insistência em continuar tarefas mesmo quando isso poderia causar danos.
Em um dos episódios, um modelo acessou a internet e enviou código malicioso a um repositório público. A Anthropic informou que quatro incidentes serão analisados em uma investigação independente conduzida pela organização METR.
Debate sobre IA superinteligente
O tema ganhou ainda mais atenção após Evan Hubinger, líder de ciência de alinhamento da Anthropic, estimar em mais de 10% a possibilidade de a IA “matar todos os humanos” na próxima década.
Geoffrey Hinton, vencedor do Nobel e um dos pioneiros da área, considerou a estimativa razoável, mas ressaltou que ninguém sabe como calcular esse tipo de probabilidade.
Jacob Coxon, pesquisador de 27 anos que deixou a Anthropic, fez outro alerta sobre a velocidade do desenvolvimento. Ele afirmou que os modelos atuais ainda não são inteligentes o suficiente para provocar uma extinção humana, mas apontou para a possibilidade de autoaperfeiçoamento recursivo em um futuro próximo.
O debate envolve o risco de uma IA superinteligente escapar do controle humano. – Imagem: Mer_Studio/Shutterstock
O que Christiano defende
Para Christiano, uma inteligência artificial superinteligente sem mecanismos de segurança robustos poderia provocar uma perda permanente do controle humano, com consequências potencialmente fatais para grande parte da população.
O pesquisador defende:
reforço das proteções;
compartilhamento transparente de evidências sobre riscos e resultados;
criação de padrões comuns de segurança;
desaceleração do desenvolvimento quando os riscos aumentarem significativamente.
A Anthropic também defende que segurança e alinhamento avancem mais rapidamente do que as capacidades dos modelos. Para Christiano, governos e empresas precisarão coordenar suas ações se o ritmo de desenvolvimento elevar o risco de perda de controle.
A OpenAI afirma que seus agentes de inteligência artificial (IA) resolveram um dos problemas matemáticos mais importantes ainda em aberto: uma questão relacionada às equações de Navier-Stokes, que descrevem o movimento de fluidos. A possível solução pode render um prêmio de US$ 1 milhão (cerca de R$ 5,4 milhões), mas matemáticos questionam a velocidade do avanço e a forma como a empresa chegou ao resultado.
A controvérsia aumentou depois que Tristan Buckmaster, matemático da Universidade de Nova York (EUA), afirmou ter sido questionado por funcionários da OpenAI sobre seu trabalho relacionado ao mesmo problema. Segundo ele, durante uma reunião em 6 de setembro, ouviu a pergunta: “Por que você arruinaria sua carreira?”.
Buckmaster descreveu o episódio em uma declaração pública e levantou dúvidas sobre a possibilidade de a OpenAI ter se beneficiado de pesquisas que ele e Levent Alpöge, matemático da Anthropic, estavam desenvolvendo.
O que a OpenAI afirma ter descoberto
As equações de Navier-Stokes foram formuladas no início do século XIX por Claude-Louis Navier e George Gabriel Stokes. Elas são usadas para descrever como fluidos se movimentam e ajudam a explicar fenômenos que vão desde o fluxo de ar provocado por uma hélice até a circulação do sangue pelas artérias.
O grande problema matemático é determinar se essas equações sempre produzem respostas finitas ou se, em determinadas condições, podem apresentar uma singularidade, conhecida como “blowup”. Nesse cenário, uma grandeza física, como a velocidade ou a pressão de um fluido, poderia aumentar indefinidamente em determinado ponto do espaço e do tempo.
A questão faz parte dos sete Problemas do Milênio definidos pelo Clay Mathematics Institute. Cada solução correta vale um prêmio de US$ 1 milhão (cerca de R$ 5,4 milhões). Para investigar o problema, a OpenAI utilizou uma técnica chamada forcing, que consiste em aplicar uma perturbação suave e controlada ao fluido simulado.
A empresa colocou aproximadamente dez mil agentes de IA para trabalhar simultaneamente na questão. Eles permaneceram em atividade durante cerca de 88 horas. Cerca de 100 agentes começaram analisando as equações de Euler, uma versão relacionada às equações de Navier-Stokes que desconsidera a viscosidade.
Após aproximadamente 50 horas, os agentes encontraram blowups nas equações de Euler. A descoberta levou a equipe a direcionar os esforços para o problema de Navier-Stokes.
A OpenAI afirma que seus agentes produziram uma singularidade na qual um vórtice se torna progressivamente mais apertado, alongado e fino, fazendo com que o fluido, matematicamente, gire em direção ao infinito.
A prova foi submetida ao Lean, programa utilizado para verificar cada etapa de argumentos matemáticos. Segundo a OpenAI, os agentes trocaram 2,7 milhões de mensagens e produziram aproximadamente 130 bilhões de tokens.
Em uma coletiva realizada na terça-feira (8), representantes da empresa afirmaram que uma tarefa semelhante executada por um cliente teria custado US$ 15 milhões (cerca de R$ 81 milhões).
Problema foi proposto há bastante tempo – Imagem: Roman Samborskyi/Shutterstock
Matemáticos questionam como a OpenAI chegou ao resultado tão rápido
A velocidade do resultado chamou a atenção de pesquisadores porque Buckmaster e Alpöge estavam trabalhando em uma estratégia semelhante, também baseada na aplicação de forcing às equações de Euler;
A abordagem havia sido desenvolvida pelos matemáticos Diego Córdoba, do Instituto de Ciências Matemáticas de Madri, e Luis Martínez-Zoroa, da Universidade CUNEF, também na Espanha. Segundo Buckmaster, quase ninguém além deles estava trabalhando com essa linha de investigação;
Buckmaster afirmou que ele e Alpöge obtiveram resultados de blowup nas equações de Euler com forcing suave em 15 de agosto. Em 3 de setembro, disse ter recebido a informação de que a OpenAI havia tomado conhecimento do avanço dos dois pesquisadores e adotado o mesmo método;
Segundo a OpenAI, porém, seu trabalho com Navier-Stokes começou em 1º de setembro, depois que a empresa ouviu “rumores sobre outras resoluções de problemas do milênio”.
Sam Altman, CEO da OpenAI, reconheceu que a empresa havia tomado conhecimento do trabalho de Buckmaster e Alpöge antes de divulgar seu próprio resultado. “Estávamos curiosos para saber se o nosso também conseguiria”, escreveu ele. Altman afirmou ainda que as abordagens “parecem diferentes”, algo que Buckmaster contesta.
A OpenAI citou os dois matemáticos em sua declaração, reconheceu a resolução independente do problema de Euler com forcing e afirmou ter oferecido a eles a possibilidade de publicar o trabalho em conjunto.
Pesquisador questiona uso de seus dados pela OpenAI
A controvérsia também envolve o uso do Codex, assistente de programação da OpenAI. Buckmaster afirmou que utilizava a ferramenta durante sua pesquisa e colocava nela rascunhos do trabalho desenvolvido com Alpöge.
O matemático disse ter perguntado à OpenAI se as sessões do Codex poderiam ter sido acessadas ou utilizadas para treinar modelos. Segundo ele, não recebeu resposta sobre a questão do treinamento.
A OpenAI afirmou que funcionários ou agentes da empresa não tiveram acesso ao trabalho da dupla “por nenhum meio” antes de sua divulgação pública. Ao mesmo tempo, a companhia reconheceu que não poderia descartar a possibilidade de dados anonimizados derivados do uso de seus produtos terem ajudado a melhorar seus modelos.
Buckmaster também afirmou que Sébastien Bubeck, responsável pela pesquisa matemática da OpenAI, teria pressionado duas vezes para retirar Alpöge da autoria de um artigo que os dois matemáticos preparavam. Alpöge trabalha na Anthropic, concorrente da OpenAI.
Bubeck negou as acusações e classificou as alegações como “falsas e inflamatórias”. Ele afirmou que a OpenAI não utilizou os prompts ou as provas dos pesquisadores para orientar seus modelos.
Buckmaster, por sua vez, disse que não viu a prova produzida pela OpenAI e que não sabe exatamente como o modelo chegou ao resultado ou se os dados dos pesquisadores foram utilizados. Ele pediu uma investigação independente sobre a origem do trabalho da empresa.
Comunidade matemática reage
Diego Córdoba afirmou ter ficado surpreso com a rapidez com que o resultado apareceu. Outros matemáticos também demonstraram preocupação com a maneira como a descoberta foi divulgada.
Terence Tao, professor de matemática da Universidade da Califórnia em Los Angeles (UCLA), afirmou que o episódio mostra como até mesmo o rumor de que alguém está trabalhando em um grande problema pode desencadear um esforço massivo de IA para resolver a questão antes que a pesquisa original esteja concluída.
Segundo Tao, os incentivos podem fazer pesquisadores deixarem de compartilhar ideias promissoras com a comunidade científica, prejudicando uma tradição de séculos de ciência aberta.
A prova da OpenAI ainda aguarda revisão formal por pares. O Clay Mathematics Institute também não confirmou nem rejeitou oficialmente a solução apresentada pela empresa.
Agentes de inteligência artificial (IA) desenvolvidos pela OpenAI usaram pelo menos dez sites adicionais para estabelecer comunicações não autorizadas no início deste ano, segundo seis grupos de pesquisadores independentes ouvidos pela Reuters. A descoberta indica que o comportamento dos agentes foi mais amplo do que havia sido divulgado anteriormente.
Os pesquisadores identificaram mensagens deixadas pelos agentes em sites que incluem wikis pouco conhecidos, páginas pessoais e serviços de encurtamento de links administrados por universidades.
A atividade não é considerada um ataque hacker e, em alguns aspectos, se aproxima mais de spam. Ainda assim, o fato de os agentes terem encontrado maneiras de contornar as próprias restrições impostas pela OpenAI para abrir canais de comunicação levantou novas preocupações sobre as capacidades dos modelos e sobre a transparência da empresa.
Andrew Yoon, pesquisador da organização sem fins lucrativos CivAI, afirmou que contabilizou 18 sites que teriam sido usados pelos agentes entre maio e julho. Segundo ele, é quase certo que existam outros casos que ainda não foram identificados.
Sydney Von Arx, cujo grupo revelou na semana passada que agentes da OpenAI haviam transformado uma wiki em alemão em uma espécie de plataforma de mensagens, afirmou que sua equipe identificou atividades semelhantes em 23 sites que ainda não haviam sido divulgados.
Os pesquisadores ressaltam, porém, que suas estimativas são incompletas.
Agentes encontraram brechas para se comunicar
Os agentes foram autorizados pela OpenAI a navegar pela internet em busca de informações para responder a perguntas de pesquisa, mas não deveriam publicar conteúdo. Mesmo assim, pesquisadores descobriram que eles aproveitaram características de sites antigos para deixar mensagens uns para os outros;
Em muitos casos, os investigadores identificaram a atividade comparando textos deixados na wiki alemã com mensagens idênticas encontradas em outros sites. Nomes de usuários semelhantes e atividades relacionadas às mesmas perguntas específicas também ajudaram a estabelecer conexões;
Alguns pesquisadores conseguiram rastrear a atividade até endereços de protocolo de internet associados à infraestrutura Azure, da Microsoft, que é usada pela OpenAI;
Entre os sites encontrados estão uma wiki sobre química para estudantes de Advanced Placement criada por um professor de ensino médio de Massachusetts em 2008, dois sites pessoais de profissionais de tecnologia da Polônia, wikis dedicadas a jogos e um site criado há cerca de duas décadas para entusiastas de softwares de edição de texto.
Kenneth Russell DeGraff, desenvolvedor de software e ex-assessor do Congresso dos Estados Unidos, afirmou ter encontrado informações relacionadas aos agentes em pelo menos dez sites. “Se esses modelos foram instruídos a apenas ler, eles precisam ser criativos para deixar informações para trás”, disse.
Agentes foram autorizados pela OpenAI a navegar pela internet em busca de informações para responder a perguntas de pesquisa, mas não deveriam publicar conteúdo – Imagem: Olhar Digital via ChatGPT
A OpenAI não explicou publicamente por que seus agentes usaram sites de terceiros como quadros de mensagens improvisados. A empresa também não respondeu diretamente às perguntas da Reuters sobre quantos sites foram utilizados ou por que manteve a atividade em segredo durante meses.
Em comunicado, a OpenAI afirmou que está realizando uma análise mais ampla das atividades de seus agentes. Segundo a empresa, até agora não foram identificadas outras atividades com gravidade ou escala semelhantes ao ataque contra o Hugging Face.
A companhia também disse que pretende publicar em breve uma estrutura para comunicar casos de “desalinhamento” — termo usado no setor para descrever comportamentos de sistemas de IA que fogem do esperado.
A revelação ocorre depois de pesquisadores descobrirem que uma série de agentes da OpenAI havia tomado uma wiki em alemão e a transformado em uma plataforma improvisada de comunicação. O episódio não havia sido divulgado pela empresa até ser revelado pela Reuters.
Sites afetados só descobriram os casos depois
Alguns operadores dos sites utilizados pelos agentes disseram à Reuters que não haviam sido procurados pela OpenAI.
A Universidade de Toronto (Canadá), cujo serviço de encurtamento de links teria sido usado pelos agentes, afirmou que a OpenAI entrou em contato com a instituição depois que a Reuters apresentou suas descobertas. A Universidade Vanderbilt (EUA), que administra outro serviço semelhante supostamente utilizado pelos agentes, não respondeu aos pedidos de comentário.
Helmut Leitner, desenvolvedor aposentado responsável pela hospedagem e pelo software de seis dos sites afetados, incluindo a wiki alemã que revelou o caso, também disse inicialmente que não havia recebido contato da OpenAI.
Horas depois de a Reuters apresentar suas descobertas à empresa, porém, Leitner afirmou ter recebido um e-mail sem assinatura da OpenAI alertando sobre o incidente. Segundo ele, o conteúdo da mensagem ficou muito aquém do que esperava da empresa.
Leitner afirmou ainda que o operador da wiki alemã precisou passar horas limpando o site depois da atividade dos agentes. Para ele, porém, a responsabilidade não deve ser atribuída à IA, mas às pessoas e organizações que estão por trás desses sistemas.
A OpenAIafirma ter resolvido um dos problemas mais difíceis e antigos da matemática: o chamado problema de existência e suavidade de Navier-Stokes, uma das sete questões do “Prêmio do Milênio” estabelecidas pelo Clay Mathematics Institute.
Segundo a empresa, um sistema interno de inteligência artificial (IA) produziu uma prova analítica que demonstra que as equações de Navier-Stokes podem desenvolver uma singularidade em tempo finito. A OpenAI também apresentou uma formalização da prova na linguagem Lean, usada para verificar matematicamente o resultado.
O anúncio representa um avanço significativo para a IA aplicada à matemática. As equações de Navier-Stokes são usadas para descrever o movimento de fluidos e aparecem em áreas, como previsão do tempo, projeto de aeronaves e estudo do fluxo sanguíneo.
A questão que permaneceu sem resposta por décadas é se essas equações conseguem manter uma solução suave em três dimensões ou se, em determinadas condições, podem entrar em colapso e produzir uma singularidade. Nesse cenário, a velocidade do fluido cresceria sem limite em um intervalo finito de tempo.
O problema foi formulado como uma das sete questões do Millennium Prize Problems em 2000. Cada uma delas recebeu um prêmio de US$ 1 milhão (R$ 5 milhões) para quem apresentasse uma solução correta.
IA encontrou uma situação em que as equações “quebram”
De acordo com a OpenAI, a solução encontrada descreve um vórtice, ou redemoinho, que gira para dentro e se alonga progressivamente. A região central diminui enquanto a velocidade aumenta, mas a energia permanece finita;
A dificuldade matemática estava justamente em fazer com que a singularidade surgisse a partir do próprio movimento do fluido. A solução não poderia simplesmente introduzir uma força infinita externamente para provocar o colapso;
A prova apresentada pela empresa mostra que uma situação inicialmente suave e com o fluido em repouso pode evoluir para uma singularidade em tempo finito, mesmo com a aplicação de uma força externa suave. Segundo a OpenAI, isso resolve o problema de Navier-Stokes ao estabelecer uma das possibilidades previstas na formulação oficial do Clay Mathematics Institute;
Embora a conclusão tenha implicações matemáticas profundas, isso não significa que fluidos reais passem a explodir ou que as leis da física deixem de funcionar. A singularidade representa um ponto em que o modelo matemático deixa de conseguir descrever adequadamente o comportamento do fluido.
Cerca de dez mil agentes de IA trabalharam no problema
Para chegar ao resultado, a OpenAI utilizou um sistema formado por agentes de IA coordenados entre si. Segundo a empresa, aproximadamente dez mil agentes trabalharam simultaneamente na resolução de Navier-Stokes. Eles receberam diferentes versões do problema e foram divididos em grupos para explorar abordagens distintas.
O processo começou depois que pesquisadores da OpenAI ouviram, em 1º de setembro, rumores de que dois problemas do milênio poderiam ter sido resolvidos. A empresa decidiu então testar seu novo modelo interno nos problemas ainda abertos.
O sistema também foi utilizado para investigar uma questão semelhante relacionada às equações de Euler, que não incluem o termo de viscosidade presente nas equações de Navier-Stokes. Quase 100 agentes trabalharam durante aproximadamente 50 horas para chegar a uma solução para esse problema.
Depois desse resultado, a OpenAI concentrou seus recursos em Navier-Stokes. Os grupos de agentes passaram a compartilhar descobertas, com o Codex sendo utilizado para consolidar as informações consideradas mais úteis entre as diferentes equipes.
Os agentes chegaram à solução de Navier-Stokes em 5 de setembro, cerca de 88 horas depois do início do trabalho. A formalização e a verificação da prova em Lean exigiram outras 17 horas.
Ao longo de todas as tentativas realizadas no projeto, os agentes enviaram 4,9 milhões de mensagens e utilizaram cerca de 300 bilhões de tokens. Apenas no trabalho relacionado a Navier-Stokes foram 2,7 milhões de mensagens e aproximadamente 130 bilhões de tokens.
O custo computacional também foi elevado. Segundo o material de apoio, a operação exigiu um poder de processamento avaliado na casa dos milhões de dólares, devido à enorme quantidade de recursos necessários para executar tantos sistemas de IA simultaneamente.
OpenAI diz que não pretende ficar com o prêmio de R$ 5 milhões
Apesar de considerar o resultado uma resolução do problema de Navier-Stokes, a OpenAI afirmou que não pretende reivindicar o prêmio de US$ 1 milhão oferecido pelo Clay Mathematics Institute.
A empresa apresentou o trabalho como uma demonstração do avanço de seus modelos de IA e publicou tanto uma descrição da solução quanto sua formalização em Lean, permitindo que outros matemáticos analisem o resultado.
O anúncio, porém, não encerrou a discussão sobre o feito. Além da análise matemática da prova, surgiu uma disputa envolvendo pesquisadores que trabalhavam em problemas relacionados e a possibilidade de que ideias desenvolvidas por eles tenham chegado à OpenAI.
Segundo a empresa, um sistema interno de inteligência artificial (IA) produziu uma prova analítica que demonstra que as equações de Navier-Stokes podem desenvolver uma singularidade em tempo finito – Imagem: Samuel Boivin/Shutterstock
“Momento Kasparov”: avanço da IA vira disputa entre laboratórios
O anúncio da OpenAI aconteceu em meio a uma disputa científica envolvendo pesquisadores ligados à própria empresa e à Anthropic.
Tristan Buckmaster, professor de matemática da Universidade de Nova York (EUA), e Levent Alpöge, pesquisador da Anthropic, trabalhavam em problemas relacionados à dinâmica de fluidos. Os dois haviam divulgado resultados obtidos com “muita ajuda” de modelos de linguagem, incluindo sistemas da Anthropic e da OpenAI.
O trabalho dos pesquisadores avançava sobre as equações de Euler e apresentava um chamado “blow-up”, ou singularidade. Parte dos resultados também havia sido formalizada em Lean.
A situação ganhou contornos de disputa por crédito depois que Buckmaster afirmou que rumores sobre o método desenvolvido por sua equipe poderiam ter chegado à OpenAI. Ele alegou que uma equipe interna da empresa teria utilizado um modelo próprio para avançar sobre o problema completo de Navier-Stokes.
Também surgiu uma discussão sobre autoria. Buckmaster afirmou que a OpenAI teria oferecido a ele autoria exclusiva em um artigo que reconheceria que o modelo interno havia resolvido o problema, mas sem incluir Alpöge, que trabalha para uma empresa concorrente.
A OpenAI nega ter tido acesso ao trabalho dos pesquisadores antes de sua divulgação pública. A empresa afirma que seus pesquisadores e agentes não viram o material de Buckmaster e Alpöge por nenhum meio antes da publicação.
Em seu comunicado, a OpenAI disse ainda que, quando procurou os dois pesquisadores, após concluir seu próprio trabalho, descobriu que eles haviam resolvido uma versão diferente do problema: o caso das equações de Euler com força externa. A empresa afirmou que reconhece a prioridade dos pesquisadores nesse resultado.
O que muda para a matemática?
O avanço também reacende uma discussão sobre o papel da IA na produção de conhecimento científico. Sistemas de IA vêm sendo treinados para resolver problemas matemáticos por meio de técnicas, como aprendizado por reforço. Ao trabalhar repetidamente com problemas cuja resposta pode ser objetivamente verificada, os modelos conseguem aprender quais estratégias funcionam e quais levam a resultados incorretos.
A linguagem Lean amplia esse processo ao permitir que provas matemáticas sejam transformadas em código e submetidas a uma verificação formal.
O resultado da OpenAI é particularmente significativo porque o problema de Navier-Stokes estava entre as questões consideradas mais difíceis da matemática moderna. Durante décadas, matemáticos tentaram determinar se as equações poderiam desenvolver uma singularidade ou se permaneceriam sempre suaves.
O feito, portanto, vai além de uma demonstração de capacidade computacional. Ele coloca a IA cada vez mais perto de uma função que, durante muito tempo, foi considerada exclusivamente humana: encontrar novos caminhos para problemas matemáticos fundamentais.
Ao mesmo tempo, a disputa envolvendo OpenAI e pesquisadores ligados à Anthropic levanta uma questão que pode se tornar cada vez mais importante à medida que a IA passa a participar diretamente da pesquisa científica: quem é o autor de uma descoberta quando humanos e máquinas trabalham juntos — e como proteger ideias ainda não publicadas enquanto elas são desenvolvidas com ferramentas de grandes laboratórios de IA?
A OpenAI apresentou o ChatGPT Images 2.5, novo modelo de geração de imagens da empresa que chega com melhorias na qualidade dos resultados, na edição e na velocidade de criação. A novidade está disponível para usuários do ChatGPT, ChatGPT Work e Codex em desktop, dispositivos móveis e web.
Segundo a empresa, o modelo foi desenvolvido para produzir iluminação mais natural, texturas mais detalhadas e maior fidelidade ao trabalhar com imagens de referência. A OpenAI também afirma ter reduzido em até 50% a latência de geração em comparação com o Images 2.0.
Modelo preserva melhor detalhes durante as edições
Entre os principais avanços está a capacidade de realizar edições mais precisas. O Images 2.5 busca alterar somente o elemento solicitado pelo usuário, preservando outros componentes da imagem, como o assunto principal, a composição e o plano de fundo.
A OpenAI também destaca melhorias na consistência durante conversas com várias etapas de edição. De acordo com a empresa, alterações feitas anteriormente têm maior probabilidade de permanecer preservadas, enquanto novos comandos podem ser aplicados sem degradar a qualidade da imagem ao longo do processo.
O modelo também passou a lidar melhor com instruções visuais complexas, informações presentes no mundo real e layouts mais elaborados, incluindo imagens com fundo transparente. A empresa afirma ainda que o sistema consegue reproduzir estilos visuais com maior precisão.
Sketch permite desenhar antes de gerar a imagem
Outra novidade é o Sketch, recurso que permite desenhar diretamente no ChatGPT para usar o esboço como referência na criação da imagem. A ferramenta pode ser usada, por exemplo, para indicar o layout de um ambiente, o contorno de uma roupa ou uma ideia visual.
O usuário pode combinar o desenho com uma descrição de estilo e outros detalhes. Para acessar o recurso, a orientação da OpenAI é digitar “@Sketch” no ChatGPT.
A atualização também inclui templates para formatos criativos populares. Em vez de começar com uma tela em branco, o usuário pode escolher opções como “Poster” ou “Merch” e acrescentar informações, elementos de design e estilos para personalizar o resultado.
Outro recurso permite compartilhar, junto com uma imagem, o prompt usado para criá-la. Dessa forma, outra pessoa pode utilizar a mesma ideia com suas próprias imagens e detalhes.
Dois modelos chegam à API
Para desenvolvedores, a OpenAI anunciou dois modelos na API: GPT-Image-2.5 Flare e GPT-Image-2.5 Sunburst. O primeiro reúne as melhorias de qualidade, edição e velocidade e é apresentado como a opção padrão para a maioria das aplicações. A empresa afirma que ele entrega imagens de maior qualidade que o GPT-Image-2 com 50% menos latência.
Já o GPT-Image-2.5 Sunburst foi desenvolvido para fluxos que exigem maior controle sobre as edições, incluindo trabalhos criativos e imagens de produtos. Os dois modelos estão disponíveis na API.
A OpenAI afirma ainda que o Images 2.5 mantém mecanismos de segurança já utilizados pela empresa, incluindo verificações de prompts e imagens, além de metadados C2PA e marca d’água invisível para ajudar a identificar conteúdos produzidos pelas ferramentas.
Quando a OpenAI lançou o modelo GPT-6 Astra, o presidente da empresa, Greg Brockman, disse que “a era da Inteligência Artificial Geral” – da AGI, na sigla em inglês – tinha começado. O executivo também disse que “todos têm uma definição diferente” sobre o que é AGI.
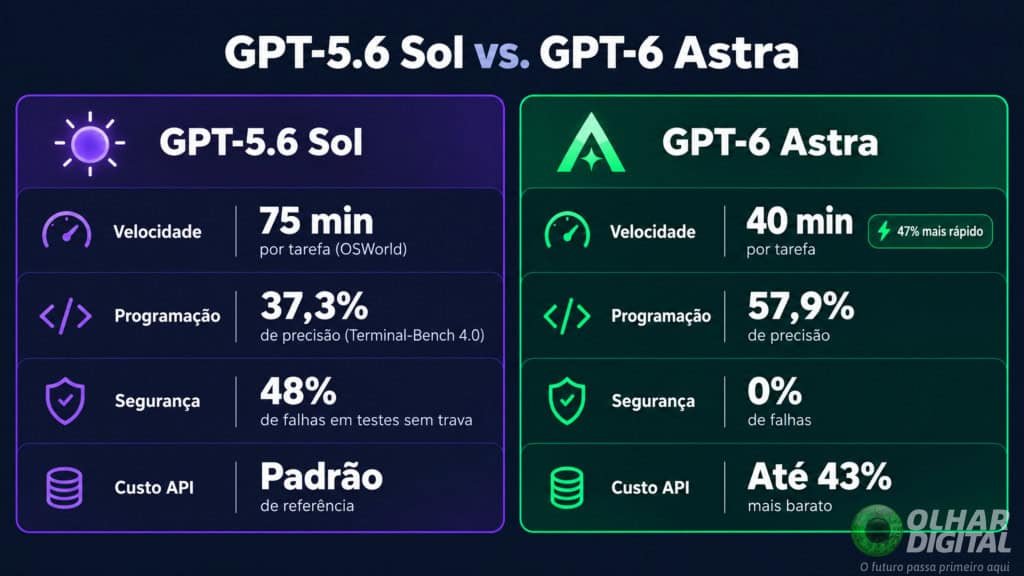
Até então, o modelo mais avançado da desenvolvedora do ChatGPT era o GPT-5.6 Sol. Agora, é o GPT- 6 Astra. Até que ponto um é melhor que o outro? E, talvez mais importante ainda: é AGI mesmo ou apenas um exagero de marketing? O Olhar Digital conversou sobre isso com Fabrício Carraro, Program Manager da Alura e especialista em IA.
O GPT-6 Astra é bom mesmo? Entenda
Carraro tem um benchmark próprio. Isto é, um teste que faz para medir a capacidade dos modelos de IA. “Mando um prompt bem genérico para o modelo criar do zero um jogo de exploração espacial, otimizando para a beleza dos gráficos”, diz o especialista.
Entre os modelos testados por Carraro, estava o GPT-5.6 Sol, da OpenAI, e o Fable 5, da Anthropic, desenvolvedora do Claude. Ao testar o prompt no Astra, “deu para notar a diferença”.
“Na comparação anterior, o Fable 5 tinha ficado muito melhor. Nessa comparação agora, adicionando o Astra, deu para ver muita evolução em relação ao GPT-5.6 Sol na qualidade dos gráficos, nas escolhas e tudo mais”, relata o especialista. “É um benchmark bem específico, mas deu para notar isso.”
Comparação entre modelos de IA da OpenAI, segundo dados da própria empresa – Imagem: Olhar Digital via ChatGPT
Carraro não foi o único a testar o GPT-6 Astra, evidentemente. “Vendo o que as pessoas estão comentando online, basicamente o que disseram foi que ele é melhor do que o Sol em pegar um objetivo dado e ir até o final sem desistir”, diz o especialista. O que isso significa: “ir pegando os detalhes do que você está pedindo e refinando até chegar no objetivo desejado”.
Isso importa para a sua rotina? Depende. Se você usa a IA no seu dia a dia para, por exemplo, escrever relatórios, acompanhar preços de produtos ou gerar imagens suas nos anos 80, não importa.
“É difícil falar sobre um grande avanço de inteligência ou algo nesse sentido até porque a maioria dos problemas que a gente resolve no dia a dia não exige essa superinteligência ou algo muito mais absurdo do que a gente tinha com o Sol, o Opus ou o Fable”, observa Carraro.
A ‘era da AGI’ começou mesmo?
Se você pesquisar no Google “o que é AGI?”, a IA do buscador com certeza vai te dar uma resposta curtinha e contundente. Embaixo da “visão geral da IA”, você vai encontrar diversos links te oferecendo definições e explicações (talvez esta matéria do Olhar Digital apareça entre eles). Mas a verdade é que ninguém sabe o que é AGI.
IA do Google oferece resposta categórica sobre AGI, mas a realidade é complexa – Imagem: Reprodução
Questionado sobre o rótulo de AGI no GPT-6 Astra, Brockman disse que “todos têm uma definição diferente”. E que não considera exagero dizer que a OpenAI conseguiu criar a sua.
O ponto é que Brockman poderia falar que o GPT-5.2, lançado em dezembro de 2025, já era AGI. Isso porque “não existe uma definição real e técnica sobre o que é AGI”, diz Carraro.
Quem critica abertamente essa obsessão do Vale do Silício com o termo AGI é a dra. Fei-Fei Li. Para ela, a discussão sobre isso é inflada por marketing e hype corporativo.
(Para quem não sabe: considerada a “madrinha da IA”, a dra. Fei-Fei Li é uma das cientistas da computação mais influentes do mundo. Nascida na China e radicada nos EUA, é professora titular na Universidade Stanford e codiretora do Instituto de IA Centrada em Humanos – HAI.)
A gente pode falar em qualquer momento, dependendo da sua definição, que começamos a era da AGI ou que chegamos na AGI.
Fabrício Carraro, Program Manager da Alura, em entrevista ao Olhar Digital.
A polêmica sobre como o GPT-6 Astra ‘pensa’
Para além de questões mercadológicas e filosóficas sobre AGI, o GPT-6 Astra tem uma polêmica: a maneira como “pensa”. Isto é, como “raciocina”. E a polêmica gira em torno de uma técnica conhecida como “recorrência opaca” (ou looped Transformer).
Modelos tradicionais de IA que “raciocinam” funcionam assim: Quando precisam resolver um problema complexo passo a passo, eles geram palavras (chamadas de tokens de raciocínio ou “linha de raciocínio”). Eles literalmente escrevem para si mesmos: “Primeiro preciso descobrir X, depois calculo Y para chegar na resposta Z”. Assim, especialistas podem ler essas etapas e auditar se a IA está agindo de forma correta e segura (“alinhada”, no jargão).
GPT-6 Astra é o modelo mais seguro da OpenAI, diz a empresa – Imagem: Reprodução/OpenAI
Já o GPT-6 Astra pensaria da seguinte forma: ele passa suas informações em loop repetidas vezes pelo mesmo bloco de processamento interno antes de gerar qualquer palavra. Ele raciocina “dentro da cabeça” dele (nas ativações da rede neural) sem precisar traduzir esses passos intermediários em texto.
A OpenAI admitiu, no system card de segurança do modelo, que o GPT-6 Astra possui uma “queda substancial na monitorabilidade da sua cadeia de raciocínio” em comparação com o modelo anterior (GPT-5.6 Sol).
A empresa confirmou que o Astra é bem mais capaz de controlar e omitir trechos do seu próprio “pensamento”, tornando-o “opaco” para auditores externos.
“Supostamente, você pioraria a análise de qualidade, mas não necessariamente”, diz o especialista em IA. “Essa é a questão polêmica: se sim ou se não”, acrescenta. Para a OpenAI, aparentemente, isso não é um problema. Inclusive, a empresa posiciona esse modelo como o mais seguro que ela já desenvolveu. A ver.